2x RTX 5060 Ti vs GB10: Por que 32 GB de VRAM perde para 128 GB de memória unificada
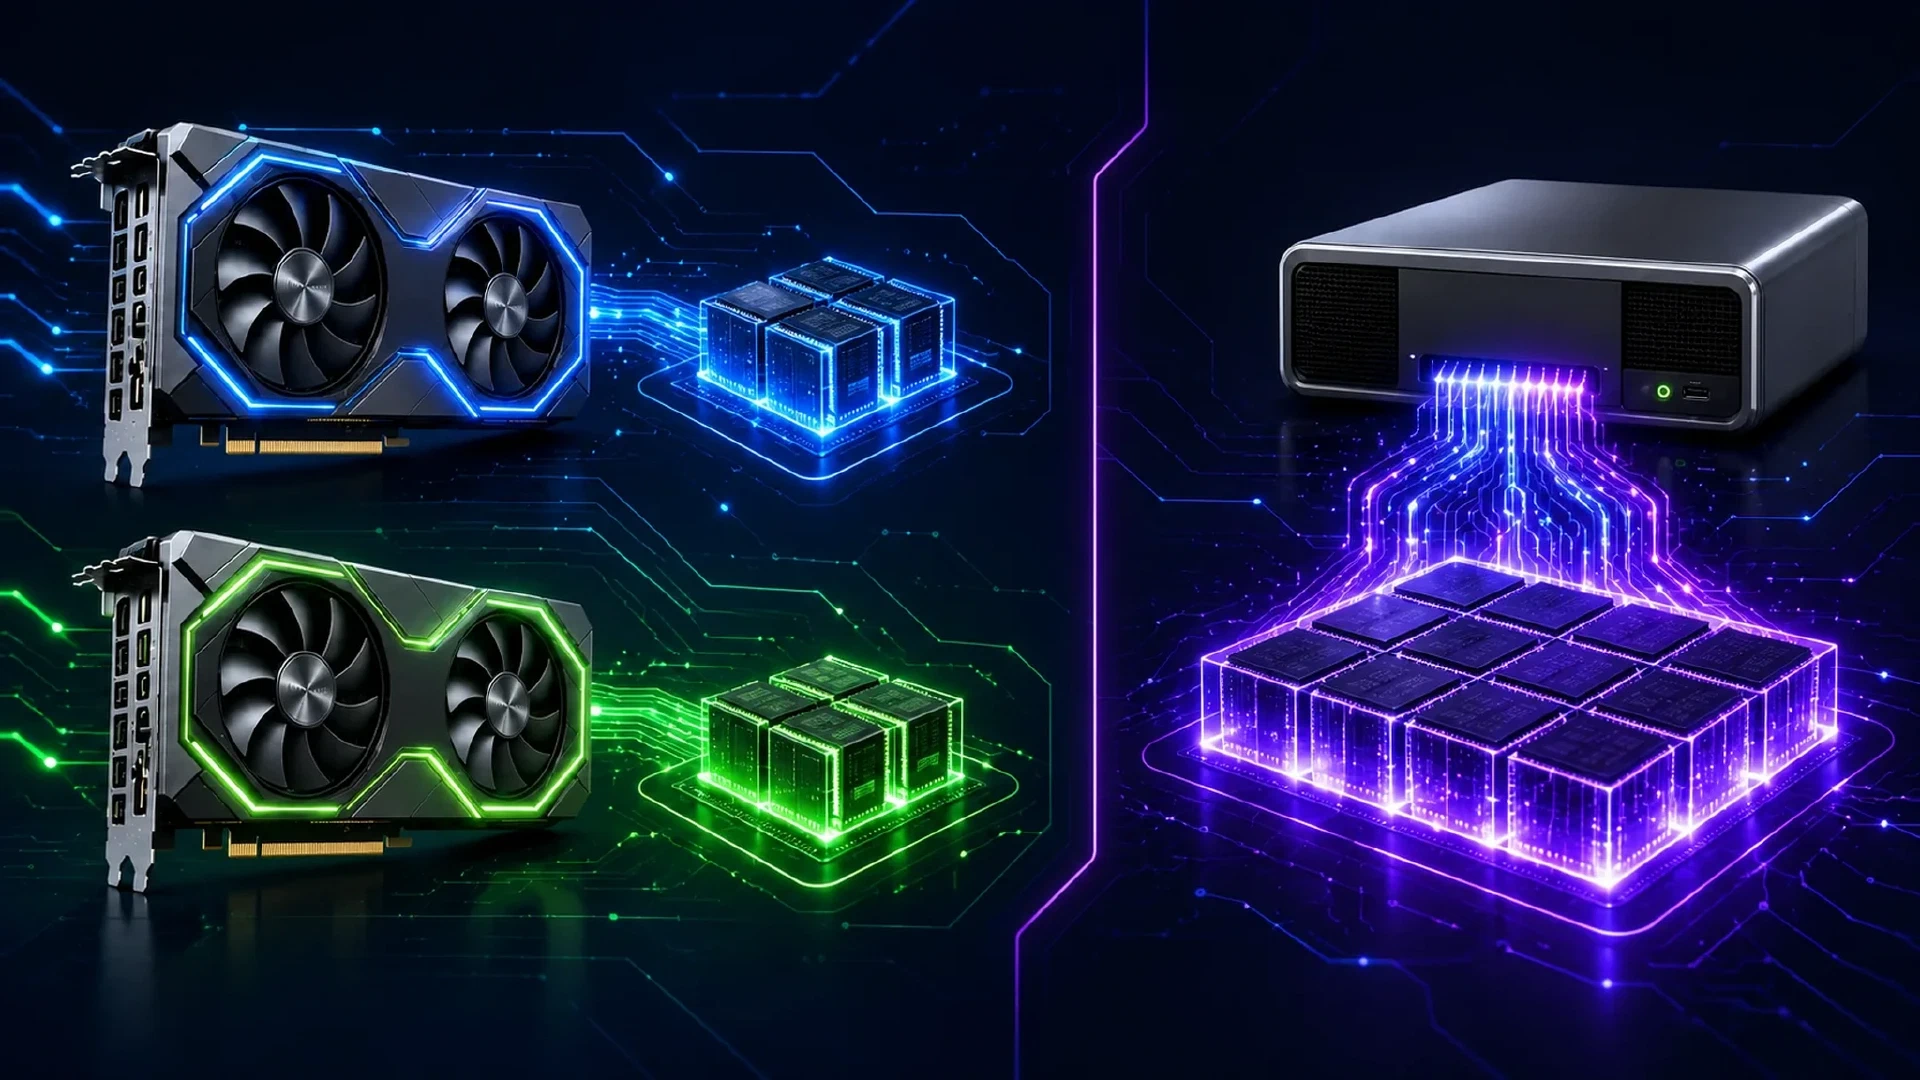
Table of Contents
Duas placas RTX 5060 Ti de 16 GB parecem atraentes em uma lista de peças. Elas oferecem 32 GB de VRAM agregada e processamento rápido de prompts com contexto curto. A comparação muda quando você executa um modelo 27B com contexto longo.
O sistema NVIDIA GB10 usa 128 GB de memória unificada coerente. A NVIDIA lista a plataforma GB10 com 128 GB de memória unificada LPDDR5x e TDP de 140 W para o chip. A RTX 5060 Ti usa 16 GB de GDDR7 por placa, interface de memória de 128 bits e potência gráfica total de 180 W. Especificações da NVIDIA RTX 5060 Ti e especificações da NVIDIA GB10 deixam clara a diferença de hardware.
O ponto é simples. Duas placas de 16 GB não criam um único pool rápido de memória de 32 GB. Elas criam dois pools separados de 16 GB conectados pelo sistema host. Para inferência de modelos grandes, a capacidade ausente e o movimento de dados entre dispositivos importam mais que a quantidade de placas.
Comparação de memória
| Sistema | Memória | Modelo de memória | Potência informada |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | 32 GB agregados | Dois pools separados de memória de GPU | 360 W de GPU no total |
| Sistema GB10 | 128 GB | Memória de sistema unificada coerente | TDP GB10 de 140 W |
O GB10 não vence porque 128 GB de memória LPDDR5x iguala a largura de banda de uma GPU discreta de alto nível. A vantagem vem da capacidade e da disposição. CPU e GPU compartilham o mesmo espaço de endereços, então o modelo, os buffers de runtime, as ativações e os dados de contexto não precisam caber em dois dispositivos isolados de 16 GB.
O sistema de duas placas enfrenta um problema de disposição mais difícil. O modelo precisa caber nas duas placas. O runtime de inferência precisa mover dados entre elas. O tráfego PCIe adiciona latência e consome largura de banda. A RTX 5060 Ti também não oferece suporte a NVLink, segundo as especificações da NVIDIA.
Resultado do benchmark
Os resultados abaixo vêm do relatório de benchmark de IA fornecido. O relatório compara um sistema dual-GPU sem nome, chamado 5060ti-x2, com um sistema GB10. O teste cobre Qwen e GPT-OSS em vários tamanhos de contexto.
Os modelos vieram diretamente do Ollama. O teste usou as tags padrão literais qwen3.8:27b e gpt-oss:latest, sem Modelfile personalizado ou quantização alternativa. O sistema 5060ti-x2 usou PCIe Gen4 x16 e os drivers NVIDIA para Linux mais recentes disponíveis quando o benchmark foi executado.
Processamento de prompt e geração do Qwen
| Contexto | Prompt 5060ti-x2 tok/s | Geração 5060ti-x2 tok/s | Prompt GB10 tok/s | Geração GB10 tok/s |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
Em 4K, o sistema de duas placas gera cerca de duas vezes mais rápido que o GB10. Em 64K, a vantagem cai para cerca de 1,5 vez. Em 128K, os sistemas alcançam velocidades de geração aproximadamente iguais.
Em 256K, a comparação deixa de parecer uma vitória da configuração de duas placas. A solicitação 5060ti-x2 alcançou somente 171.359 tokens reais de prompt. A geração caiu para 1,2 tokens por segundo. O GB10 concluiu o teste completo de 256K a 25,8 tokens por segundo.
No resultado de 256K testado, o GB10 gerou cerca de 21,5 vezes mais rápido. Mais importante, o GB10 concluiu o contexto solicitado. O sistema de duas placas não entregou a mesma carga de trabalho.
Por que a VRAM agregada engana
1. O modelo não vê uma placa de 32 GB
Duas GPUs não fundem a memória em um único espaço de endereços local. Um runtime model-parallel divide camadas ou tensores entre dispositivos. Cada dispositivo ainda precisa de espaço para seus pesos atribuídos, buffers temporários e parte do estado de contexto.
A capacidade utilizável fica abaixo do que a soma simples sugere. A sobrecarga exata depende do formato do modelo, da quantização, do backend de inferência, da divisão de tensores e do tamanho do contexto.
2. A memória de contexto cresce durante a geração
Os pesos do modelo são apenas uma parte do orçamento de memória. O key-value cache, ou KV cache, armazena dados de atenção dos tokens anteriores. Contextos longos exigem mais memória de cache. Um teste de 4K não prevê uma implantação de 128K ou 256K.
Os resultados fornecidos mostram esse limite com clareza. O sistema de duas placas mantém uma forte vantagem no processamento de prompts, depois perde desempenho de geração conforme o contexto cresce. O GB10 fica perto de 26 a 29 tokens de geração por segundo de 4K a 256K.
3. Transferências PCIe adicionam custo
Quando o runtime move ativações ou tensores entre GPUs, a transferência atravessa o interconector do host. Isso cria pontos de sincronização e adiciona latência a cada etapa. A penalidade cresce quando a carga atravessa repetidamente a fronteira entre dispositivos.
Isso não torna um sistema dual-GPU inútil. A disposição da memória faz parte do resultado de desempenho. Um benchmark que informa apenas o processamento de prompts em 4K ignora esse custo.
4. A eficiência energética é uma vantagem do sistema
Na comparação, o GB10 usa menos energia e oferece mais capacidade de memória para a carga de trabalho com contexto longo testada. Duas placas RTX 5060 Ti têm uma potência combinada de GPU de 360 W antes do restante do sistema. A NVIDIA lista o TDP do GB10 em 140 W.
O GB10 troca a velocidade máxima em contexto curto por capacidade, conclusão e menor potência de GPU. Esses compromissos importam para inferência Qwen com contexto longo.
O sistema 5060ti-x2 custa muito menos
A comparação de desempenho não elimina a diferença de preço. Uma estação de trabalho completa com duas RTX 5060 Ti de 16 GB foi listada por $3,479 em 10 de outubro de 2026. A configuração inclui Intel Ultra 7 265K, placa-mãe Z890, 32 GB de DDR5, armazenamento de 1 TB, fonte de 1.000 W e as duas GPUs. Veja a listagem completa da estação dual-GPU .
O marketplace dos EUA da NVIDIA lista o DGX Spark de 128 GB por $6,950. A listagem inclui 128 GB de memória unificada coerente e 4 TB de armazenamento NVMe, mas mostra o sistema fora de estoque. Confira a listagem atual do DGX Spark da NVIDIA .
A AMD Ryzen AI Halo Developer Platform oferece outro ponto de comparação. Esse sistema Strix Halo custa $3,999.99 na Micro Center, com 128 GB de memória unificada LPDDR5x e 2 TB de armazenamento. O Strix Halo costuma entrar na mesma classe prática de IA local dos sistemas GB10, embora testes independentes frequentemente meçam o GB10 à frente em throughput e maturidade de software. Confira a listagem Linux atual da Micro Center e leia a análise do Strix Halo contra o GB10 .
| Sistema completo | Preço listado em 10 de outubro de 2026 | Diferença de preço |
|---|---|---|
| Estação 5060ti-x2 | $3,479 | Base |
| AMD Ryzen AI Halo, Strix Halo | $3,999.99 | $520.99 a mais |
| GB10 DGX Spark de 128 GB | $6,950 | $3,471 a mais |
O GB10 oferece um pool maior de memória unificada, menor consumo de energia e uma arquitetura melhor para contexto longo. O sistema AMD oferece a mesma classe de memória de 128 GB por cerca de $4.000. A estação 5060ti-x2 continua em cerca de 50% do preço listado do GB10, antes de impostos e frete. Quem precisa de memória unificada, mas não do stack de software da NVIDIA, tem uma alternativa de menor custo no Strix Halo.
Esses são preços listados por fornecedores diferentes, não uma cesta de varejo controlada. A comparação também deixa o sistema 5060ti-x2 com menos memória de sistema e armazenamento. A diferença de preço ainda importa porque as duas listagens descrevem computadores completos e utilizáveis, não apenas preços de GPUs. As listagens atuais de placas RTX 5060 Ti de 16 GB ficam perto de $789 a $830 cada, muito acima do MSRP de lançamento de $429. A vantagem de preço de duas placas permanece mesmo durante o aumento atual nos preços de GPUs. Preços atuais da RTX 5060 Ti .
O resultado do GPT-OSS precisa de tratamento separado
O mesmo relatório mostra resultados fortes de geração do 5060ti-x2 para GPT-OSS de 4K a 256K. O GB10 conclui os testes de 4K a 128K, mas o teste GPT-OSS de 256K aparece como unsupported.
Não use a tabela GPT-OSS para declarar um vencedor universal. Os testes não cobrem o mesmo intervalo em 256K. O resultado Qwen oferece a comparação de contexto longo mais limpa porque os dois sistemas informam um resultado de 256K, embora a execução 5060ti-x2 tenha alcançado somente 171.359 tokens reais de prompt.
O que isso significa para uma configuração Qwen 3 27B
Uma configuração com duas placas de 16 GB pode executar um modelo 27B quantizado em um contexto menor. O benchmark não refuta esse uso. Os dados refutam a afirmação de que 32 GB de VRAM agregada oferecem a mesma folga prática de um sistema com 128 GB de memória unificada.
A capacidade de caber em uma placa prova apenas a capacidade para os pesos. A necessidade real de memória é pesos do modelo mais contexto ativo, KV cache, buffers de runtime e folga do sistema operacional. O contexto precisa caber junto do modelo. Um modelo que carrega, mas não tem espaço para a conversa de trabalho, não é uma configuração de contexto longo utilizável.
Isso corresponde às orientações de dimensionamento em 16 GB de VRAM são suficientes para trabalho sério com LLM local? , que tratam pesos, contexto e alocações do runtime como um orçamento. O guia de 32 GB de VRAM para Qwen 27B chega à mesma conclusão para configurações de duas placas. Capacidade agregada não equivale a folga utilizável.
Para uma implantação Qwen 3 27B, faça quatro perguntas antes de comprar hardware:
- A quantização solicitada cabe com os buffers do runtime? Os pesos sozinhos não definem a necessidade de memória.
- O contexto cabe sem pressão severa sobre o KV cache? Prompts longos mudam o resultado.
- O runtime usa uma divisão rápida entre dispositivos? Transferências PCIe e disposição dos tensores afetam cada token gerado.
- O sistema conclui o contexto-alvo? Um resultado rápido em 4K não compensa uma carga 256K malsucedida.
O teste fornecido responde à última pergunta para o sistema de duas placas. A execução alcançou 171.359 tokens durante a solicitação Qwen 256K e gerou a 1,2 tokens por segundo. O GB10 concluiu 256K a 25,8 tokens por segundo.
Para esta carga de trabalho com contexto longo, a memória unificada é a melhor arquitetura quando a alternativa depende de PCIe para abranger o conjunto de trabalho do modelo. PCIe continua sendo uma solução de capacidade. PCIe não cria o mesmo pool de memória, latência ou caminho de transferência. O guia de contexto de GPU para IA local explica por que pesos do modelo, KV cache, saída de ferramentas e buffers de runtime precisam ser dimensionados juntos. O benchmark de GPU do Ollama Qwen3.8 27B também mostra por que resultados de contexto longo precisam de atenção separada dos números de decodificação em contexto curto.
Veredito
Duas RTX 5060 Ti de 16 GB são um substituto fraco para um GB10 quando o objetivo é inferência 27B com contexto longo. Elas entregam maior throughput de prompts em tamanhos de contexto curtos. Também usam mais potência de GPU e expõem o runtime a um layout de memória dividido.
O GB10 é mais lento no processamento de prompts nos resultados fornecidos. O sistema é mais eficiente em energia, oferece quatro vezes a memória agregada e conclui o teste Qwen completo de 256K com velocidade de geração utilizável.
Se você executa prompts curtos e valoriza a ingestão de prompts, o 5060ti-x2 tem um caso restrito. Para um modelo 27B, o pool maior de memória unificada é a melhor escolha porque o modelo e o contexto compartilham um conjunto de trabalho coerente. A memória unificada continua preferível quando transferências PCIe entram no caminho de inferência.
O benchmark não mostra que duas RTX 5060 Ti nunca iniciam Qwen 3 27B. Os dados mostram por que iniciar o modelo é diferente de executar bem a carga de trabalho.
Limitações do benchmark
O relatório fornecido identifica as tags literais do Ollama, mas não registra os digests de manifest resolvidos, revisões dos modelos, CPU, medições de energia ou configuração de refrigeração. O relatório também identifica PCIe Gen4 x16 para o sistema 5060ti-x2 e os drivers NVIDIA atuais para Linux no momento do teste. Trate os números como uma comparação observada entre sistemas, não como um ranking universal de todo par de RTX 5060 Ti e toda implementação GB10.
As especificações de hardware acima vêm da NVIDIA. Os números de desempenho vêm dos dados de benchmark fornecidos para este artigo.
Referências
- Biblioteca de modelos Ollama Qwen3.8
- Tags de modelos Ollama GPT-OSS
- 16 GB de VRAM são suficientes para trabalho sério com LLM local?
- 32 GB de VRAM para Qwen 27B
- Guia de contexto de GPU para IA local
- Benchmarks de GPU Qwen3.8 27B na Vast.ai
- Listagem de estação de trabalho com duas RTX 5060 Ti de 16 GB
- Listagem do NVIDIA DGX Spark no marketplace dos EUA
- Listagem Linux AMD Ryzen AI Halo de 128 GB
- Análise da Tom’s Hardware sobre Strix Halo e GB10
- Verificação atual de preços da RTX 5060 Ti
Related Posts