Certificações de cibersegurança em IA: atrasadas em relação à prática

Table of Contents
Fizemos as provas. Passamos. Saímos com certificados e um nível de decepção que quero explicar com precisão.
Esta não é uma crítica às pessoas que criaram esses programas. Elas trabalham com material incompleto. A segurança de IA ainda é uma disciplina jovem. A pesquisa sobre ataques avança mais rápido do que as ferramentas de defesa. Os frameworks de governança surgiram antes das orientações de engenharia.
O problema está na distância entre o que as certificações ensinam e o que você precisa saber para proteger sistemas de IA em produção.
Três camadas que se confundem com frequência
Antes de explicar o que falta, vale separar o que já existe.
A primeira camada é a governança. Documentos como o NIST AI Risk Management Framework (AI RMF 1.0, 2023), a ISO/IEC 42001:2023 e o EU AI Act atuam no nível organizacional e de processos. Eles descrevem como gerenciar riscos de IA, estruturar a supervisão e documentar a responsabilidade. O foco deliberado é a governança, não a especificação de controles. Essa é a intenção do desenho.
A segunda camada é a taxonomia de ameaças. O MITRE ATLAS documenta táticas adversariais contra sistemas de IA no mesmo formato do ATT&CK. O OWASP Top 10 for Large Language Model Applications enumera as classes de ataque mais relevantes para LLMs implantados. Esses documentos nomeiam os ataques e explicam como funcionam. Eles não prescrevem defesas.
A terceira camada é a orientação técnica. Ela inclui o Google’s Secure AI Framework (SAIF), o Microsoft’s AI Security SDL, o OWASP AI Exchange, o NIST AI 600-1 (Generative AI Profile) e a documentação de segurança específica de fornecedores como Anthropic, OpenAI e Meta. Esses recursos oferecem orientação de engenharia sobre implantação segura, práticas de avaliação e controles em tempo de execução.
A maioria das certificações de governança de IA cobre a primeira camada em profundidade. Menciona a segunda em nível geral. Raramente aborda a terceira.
O que as certificações cobrem
As certificações de governança e segurança de IA disponíveis, incluindo IAPP AI Governance Professional (AIGP), ISACA AI Fundamentals Certificate, certificações ISO 42001 e CompTIA AI+, cobrem um conjunto semelhante de temas.
Você aprende o NIST AI RMF e como relacionar suas quatro funções, Govern, Map, Measure e Manage, à implantação de IA da sua organização. Aprende as classificações de risco do EU AI Act e como funciona a avaliação de conformidade para sistemas de alto risco. Aprende sobre viés, equidade, transparência e responsabilidade como princípios de governança. Aprende a redigir políticas de governança de IA e realizar avaliações de impacto.
Essas são competências reais. As organizações precisam de pessoas que entendam frameworks de governança e leiam o NIST AI RMF para saber o que ele pede que construam.
O que as certificações não ensinam com a mesma profundidade:
- Como os invasores comprometem hoje sistemas de IA em produção
- Como funciona na prática a defesa em profundidade contra injeção de prompt e por que nenhum controle isolado a elimina
- Como verificar a integridade dos modelos antes da implantação
- O que envolve o red teaming específico para IA e como definir seu escopo
- Como avaliar o comportamento do modelo diante de entradas adversariais antes do lançamento
- Como é a observabilidade de IA durante a inferência
- Como a resposta a incidentes de IA difere dos playbooks tradicionais de IR
- O que é necessário para proteger agentes de IA com acesso a ferramentas e integrações externas
O NIST AI RMF trata de governança, não de engenharia
O NIST AI RMF é um documento bem construído. O NIST o projetou para ser neutro em relação à tecnologia, independente do setor e aplicável a diferentes abordagens de desenvolvimento de IA. Isso resulta em um framework de ampla aplicação.
Também significa que ele não prescreve controles técnicos para classes específicas de ataque. Se sua organização adotar o AI RMF integralmente e relacionar todas as funções à implantação de IA, terá processos de risco documentados. Isso não garante uma defesa contra injeção de prompt no modelo de linguagem implantado.
O NIST reconhece essa limitação. O NIST AI 600-1, Generative AI Profile, lançado em 2024, amplia o AI RMF especificamente para IA generativa e modelos de linguagem grandes. Ele cobre riscos como injeção de prompt, envenenamento de dados e riscos informacionais com um nível de detalhe que o AI RMF básico não alcança. Se sua certificação cobriu o AI RMF básico sem o AI 600-1, você deixou de estudar o documento mais relevante para os sistemas implantados hoje.
ISO 42001 e a comparação com sistemas de gestão
A ISO 42001:2023 é um padrão de sistema de gestão de IA. Ela fornece uma estrutura para governar o desenvolvimento e a implantação de IA no nível organizacional. Profissionais de segurança reconhecerão a semelhança com a ISO 27001, voltada à segurança da informação.
A ISO 27001 é amplamente adotada. Organizações certificadas ainda sofrem invasões. A certificação documenta que existe um sistema de gestão, que ele segue um processo definido e que passa por revisão. Ela não certifica que os sistemas sob esse processo resistem aos ataques direcionados a eles.
A ISO 42001 estabelece disciplina organizacional. A certificação informa às partes interessadas que os processos de IA estão documentados, revisados e sujeitos à governança. Ela não demonstra que os modelos implantados produzem resultados consistentes em condições adversariais, que os agentes respeitam limites de confiança definidos ou que os modelos ajustados foram criados com dados de treinamento verificados.
Essa é a mesma lacuna da ISO 27001. Aprendemos a conviver com ela na cibersegurança tradicional. Não devemos fingir que as certificações de governança de IA a eliminam quando têm a mesma limitação estrutural.
O EU AI Act exige resultados, mas não especifica a engenharia
O EU AI Act classifica sistemas de IA por nível de risco: inaceitável (proibido), alto (exige avaliação de conformidade), limitado (exige transparência) e mínimo (sem requisitos específicos).
Sistemas de alto risco, incluindo os usados em infraestrutura crítica, identificação biométrica, seleção de candidatos, educação e aplicação da lei, estão sujeitos a requisitos de documentação técnica, supervisão humana e robustez. O regulamento exige explicitamente que esses sistemas resistam a tentativas de alterar seu comportamento por manipulação adversarial.
Essa exigência está no texto legal. O regulamento especifica intencionalmente resultados, em vez de controles técnicos. Ainda não há consenso sobre métodos técnicos que demonstrem robustez adversarial em todos os contextos de implantação, sistemas e casos de uso.
Certificações baseadas no EU AI Act preparam você para classificar sistemas de IA, redigir documentação técnica e estruturar protocolos de supervisão. Elas preparam você para auditorias. O trabalho de engenharia que produz um sistema em conformidade com os requisitos de robustez pertence a outra disciplina, fora do conteúdo coberto atualmente pelas certificações.
O que está atacando sistemas de IA
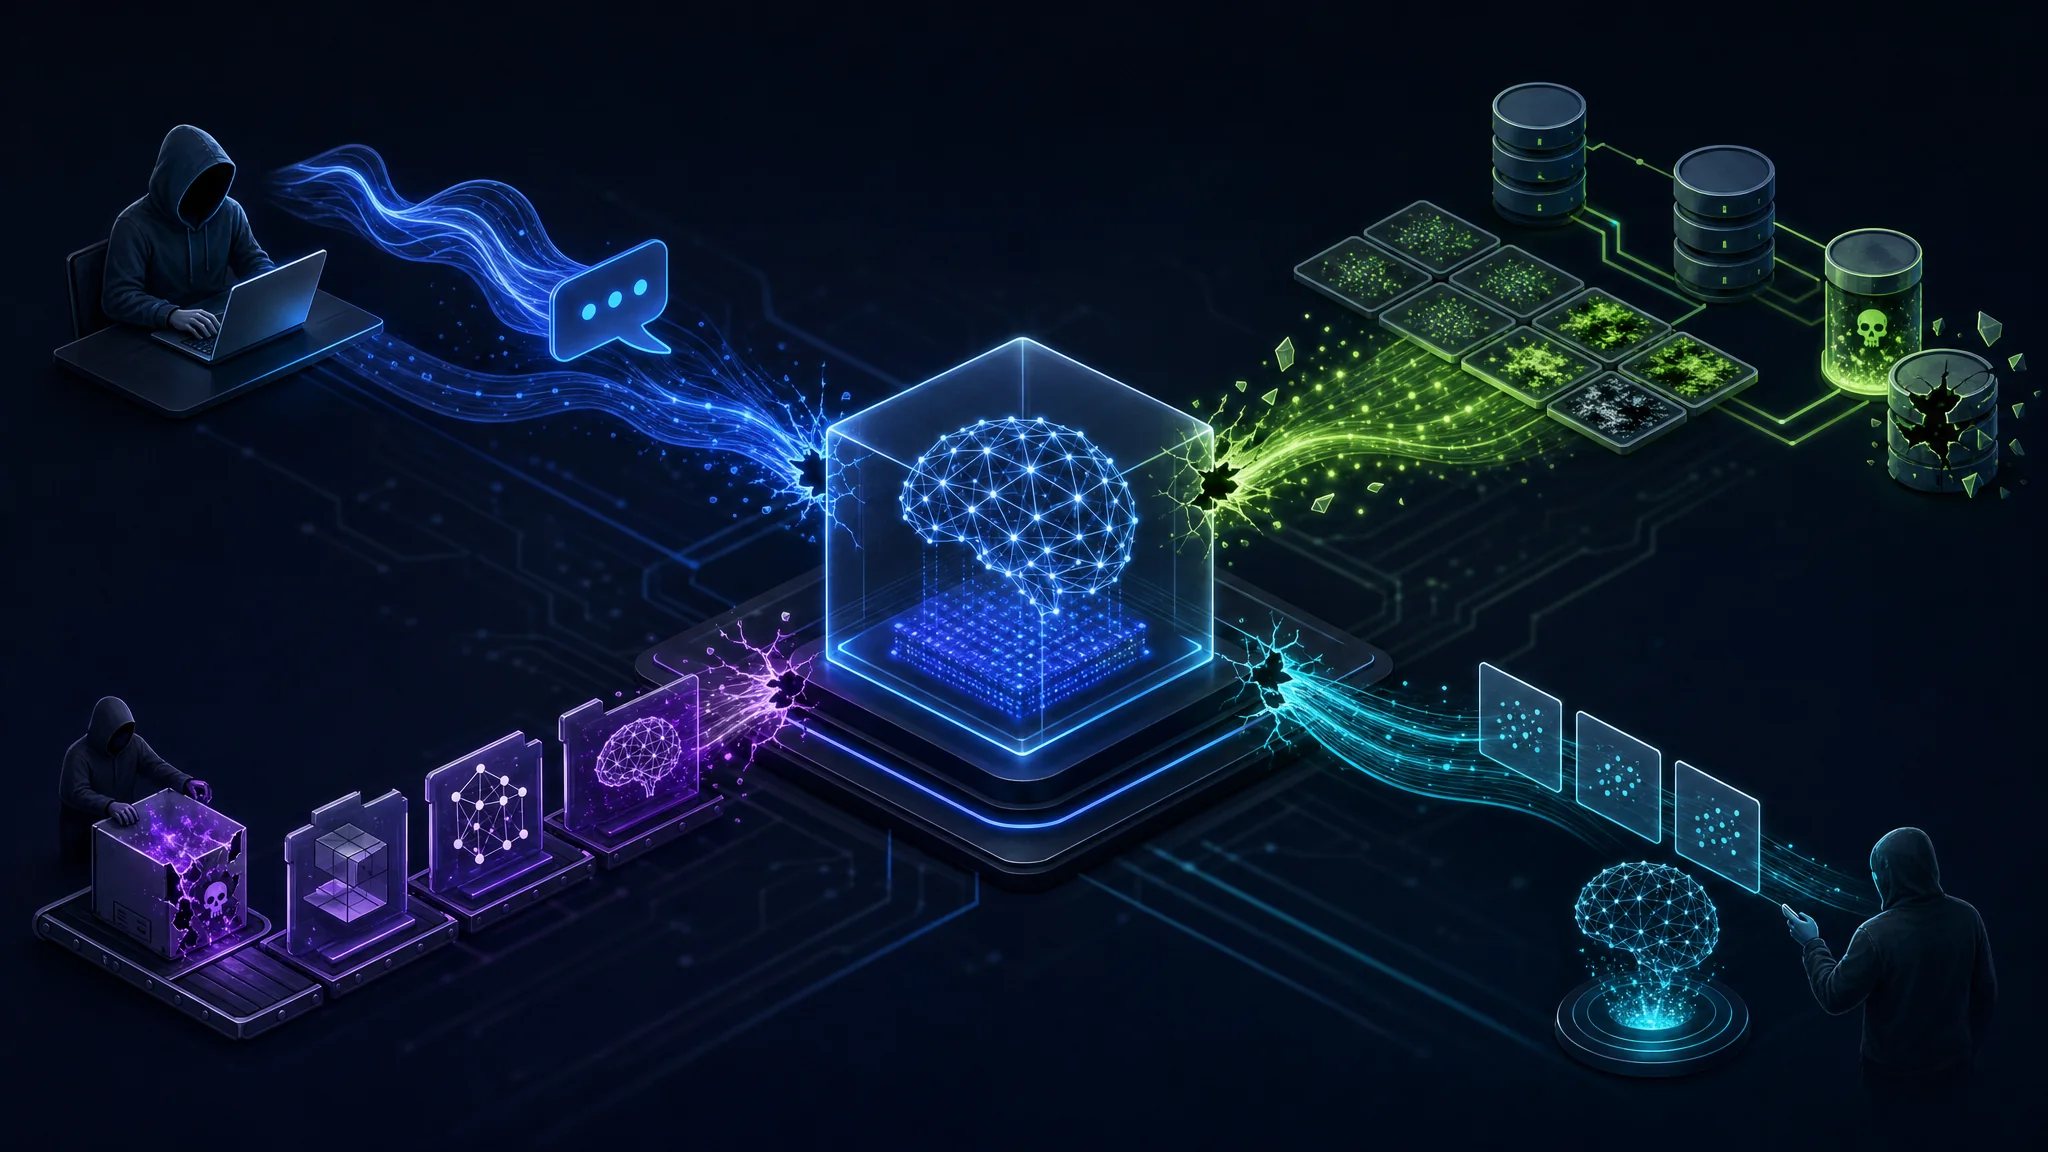
MITRE ATLAS e OWASP LLM Top 10 documentam o cenário operacional de ameaças. São recursos que enumeram ataques com um nível de detalhe útil. Frameworks de governança mencionam ameaças em nível mais abstrato. O que vem a seguir é baseado nessas fontes específicas de segurança.
A injeção de prompt funciona quando uma entrada fornecida ao modelo de linguagem substitui ou manipula instruções do sistema. A injeção direta mira a entrada do modelo. A indireta incorpora instruções maliciosas no conteúdo que o modelo recupera, processa ou resume. Sua pipeline RAG lê um documento controlado pelo invasor e segue instruções ocultas nele. Seu agente de navegação visita uma página controlada pelo invasor e segue as instruções incorporadas. Seu bot de atendimento resume um artigo de suporte que manda ignorar as diretrizes de segurança.
Em 2026, não existe uma mitigação universalmente eficaz contra injeção de prompt. A defesa em profundidade reduz o risco com filtragem de entrada, validação de saída, escopos de ferramentas com privilégios limitados, ambientes de execução isolados e etapas de aprovação humana para ações importantes. Nenhuma dessas medidas elimina a classe de ataque. NIST, OWASP, Anthropic, OpenAI, Google e Microsoft recomendam controles em camadas, em vez de uma solução única.
O envenenamento de dados de treinamento adiciona exemplos maliciosos aos dados para degradar o comportamento do modelo, inserir backdoors ou criar comportamentos acionados por gatilhos. Muitas vezes, não há sinais do envenenamento bem-sucedido até que o modelo receba entradas específicas. Se sua organização ajusta modelos com conteúdo criado por usuários, documentos recuperados ou datasets de terceiros sem verificar a origem, você enfrenta esse risco.
O comprometimento da cadeia de suprimentos de modelos é uma ameaça que muitas organizações deixam para depois. Repositórios de modelos costumam distribuir código executável junto com os pesos. Formatos de serialização inseguros, como pickle, já criaram riscos de cadeia de suprimentos repetidamente. Pacotes associados aos downloads de modelos também podem instalar dependências vulneráveis. Muitas organizações parecem aplicar muito menos escrutínio de cadeia de suprimentos aos modelos de repositórios públicos do que aplicam às dependências de software. A superfície de ataque é comparável à do npm, mas a cultura de segurança nessa área ainda é recente.
A extração de modelos permite que invasores reconstruam modelos funcionalmente semelhantes por meio de consultas de inferência repetidas à sua API. Isso representa perda de propriedade intelectual e permite estudar o modelo offline para desenvolver ataques mais direcionados.
A inferência de associação permite que invasores determinem, com diferentes níveis de confiança, se determinados registros estavam no conjunto de treinamento. Isso depende da arquitetura e do regime de treinamento do modelo. Cria riscos de privacidade para organizações que treinaram modelos com informações pessoais.
Entradas adversariais manipulam saídas do modelo por meio de perturbações elaboradas. A técnica é mais estudada em classificação de imagens, mas também se aplica a texto, áudio e sistemas multimodais. Se sua IA toma decisões sobre detecção de fraude, crédito, imagens médicas ou acesso físico, a robustez adversarial é uma propriedade de segurança que você precisa testar, não apenas documentar.
O vazamento de dados por sistemas de IA merece atenção direta. Pipelines RAG expõem documentos da base de conhecimento, às vezes a usuários sem autorização. O vazamento de prompts revela detalhes operacionais que você pretendia manter confidenciais. Implantações multi-tenant de IA exigem isolamento, uma necessidade que engenheiros de segurança de aplicações tradicionais podem subestimar. Esses riscos aparecem com frequência em sistemas implantados.
Agentes de IA mudam toda a superfície de ataque
A maioria das certificações de segurança de IA foi escrita quando sistemas de IA significavam principalmente chatbots e classificadores. Em 2026, a IA empresarial significa cada vez mais agentes.
Agentes diferem de chatbots em um aspecto operacional importante: eles agem. Um agente com acesso a ferramentas de e-mail, bancos de dados internos, sistemas de arquivos, navegador e execução de código não é um chatbot com mais recursos. É um processo autônomo com acesso significativo a sistemas reais, operando com base nas saídas de um modelo de linguagem.
A OWASP mantém agora um Agentic AI Top 10 separado, pois o modelo de ameaças dos agentes difere o bastante das aplicações de chat com LLM para exigir documentação própria.
No contexto de um agente, a injeção de prompt não produz uma resposta indesejada. Produz uma ação indesejada. Uma instrução indireta em um documento recuperado pode mandar o agente excluir arquivos, exfiltrar dados ou enviar e-mails. A consequência não é uma resposta inadequada, mas uma ação não autorizada contra sistemas acessíveis ao agente.
A superfície de ataque dos agentes inclui:
- Limites de chamada de ferramentas: se o agente está restrito ao conjunto mínimo de ferramentas adequado a cada tarefa
- Escopo de credenciais: se as credenciais do agente se limitam ao necessário para cada tarefa
- Reversibilidade de ações: se ações importantes exigem aprovação humana antes da execução
- Filtragem de saída: se as saídas do agente são validadas antes de acionar ações posteriores
- Isolamento: se o ambiente de execução impede acesso não intencional a sistemas conectados
A maioria das certificações de governança de IA não cobre o projeto de segurança de agentes nesse nível de detalhe.
Model Context Protocol cria uma nova superfície de ataque empresarial
Model Context Protocol (MCP) tornou-se um padrão amplamente adotado para conectar agentes de IA a ferramentas, fontes de dados e serviços externos. Servidores MCP expõem recursos que os agentes descobrem e usam. A integração é rápida e flexível, mas as implicações de segurança nem sempre recebem atenção equivalente.
Os riscos específicos de MCP incluem:
- Servidores MCP maliciosos que apresentam suas capacidades de forma enganosa e executam ações não pretendidas
- Envenenamento de ferramenta, quando um servidor MCP legítimo retorna dados controlados por invasores e inclui instruções em respostas que deveriam ser apenas dados
- Ferramentas com privilégios excessivos, quando integrações MCP têm permissões além do necessário para a tarefa
- Confusão dos limites de confiança, quando agentes recebem instruções de ferramentas MCP anexadas e as tratam como instruções do usuário
Organizações que implantam agentes com integrações MCP precisam de um framework para avaliar a confiança nos servidores MCP, auditar permissões de ferramentas e validar que as respostas dessas ferramentas são tratadas como dados, não como instruções.
Avaliação é a prática operacional que as certificações ignoram
Red teaming de IA e conjuntos de avaliação estão substituindo avaliações estáticas de segurança como métodos principais para entender o risco de modelos antes e depois da implantação.
Red teaming de IA envolve:
- Testes adversariais estruturados do comportamento do modelo contra técnicas de ataque conhecidas
- Benchmarking de jailbreak com datasets estabelecidos de ataques por prompt
- Testes de robustez adversarial que medem a variação das saídas diante de entradas alteradas
- Testes de regressão comportamental entre versões do modelo
- Avaliação de benchmarks de segurança com conjuntos de avaliação publicados
NIST, Anthropic, OpenAI, Microsoft, Google e CISA recomendam red teaming específico para IA antes da implantação de sistemas de alto risco. Isso está se tornando uma expectativa padrão, não uma prática opcional.
Nenhuma certificação de governança de IA atual prepara adequadamente os profissionais para definir o escopo, executar ou interpretar um exercício de red teaming contra um modelo ou agente implantado. As certificações descrevem o que é red teaming, mas não ensinam a realizá-lo.
Observabilidade de IA é uma disciplina independente
O registro tradicional de segurança não se transfere diretamente aos sistemas de IA. Monitorar um LLM ou agente em produção exige coletar dados diferentes e analisá-los de outra forma.
A infraestrutura de observabilidade de IA cobre:
- Telemetria de prompts e saídas para detectar anomalias e violações de políticas
- Logs de chamadas de ferramentas por agentes, incluindo quais ferramentas foram chamadas e com quais argumentos
- Monitoramento da qualidade de recuperação em pipelines RAG
- Detecção e classificação de tentativas de jailbreak
- Monitoramento de consistência das saídas para detectar drift entre versões do modelo
- Acompanhamento da taxa de alucinação em aplicações que exigem precisão factual
- Padrões de latência que podem indicar tentativas de injeção de prompt para aumentar o contexto
Essa disciplina está surgindo. Em 2026, a maioria das organizações que implantam IA tem muito menos observabilidade dos componentes de IA do que da infraestrutura tradicional. A maioria das certificações de governança não descreve a observabilidade adequada para sistemas de IA.
Resposta a incidentes de IA não é como a resposta tradicional
Quando um sistema tradicional é comprometido, seu playbook de IR cobre contenção, forense e recuperação. Incidentes de IA trazem perguntas que o playbook padrão não aborda.
Prepare playbooks para estas perguntas antes de precisar deles:
- Como determinar se um modelo foi envenenado durante o fine-tuning
- Como avaliar se uma recuperação RAG foi abusada para retornar conteúdo controlado por invasores
- Como identificar se um agente executou ações não autorizadas e qual foi o escopo
- Como verificar se uma atualização de modelo de um fornecedor terceirizado alterou o comportamento de forma relevante para a segurança
- Como estabelecer o comportamento do modelo antes de um incidente para compará-lo ao comportamento posterior
Essas perguntas exigem preparação antes do incidente. Exigem logs e telemetria configurados com antecedência. Exigem runbooks específicos para IA que reservem espaço para perícia do comportamento do modelo, não apenas para tráfego de rede e logs de endpoints.
O problema da atualização das certificações
Uma razão estrutural para as certificações ficarem para trás é que a segurança de IA muda mais rápido do que os ciclos de atualização permitem.
Security+, CISSP e ISO 27001 cobrem áreas que evoluem ao longo de anos. As principais superfícies de ataque de redes, endpoints e aplicações são relativamente estáveis. As técnicas de ataque à IA evoluem em meses. As técnicas de injeção de prompt, os métodos de ataque adversarial e as superfícies de ataque agêntico de 2026 são diferentes das existentes quando as primeiras certificações de IA surgiram, em 2023 e 2024.
Os órgãos de certificação atualizam os materiais segundo calendários. O OWASP LLM Top 10 publicou uma revisão importante durante seu primeiro ano. O MCP ainda não era uma preocupação empresarial quando muitas certificações atuais de IA foram planejadas. Os frameworks de segurança de IA agêntica surgiram depois da maioria dos currículos atuais.
Esse é um problema estrutural, não uma falha de intenção. Leia fontes primárias continuamente, em vez de tratar uma certificação como um corpo fixo de conhecimento.
O que deve fazer parte do conteúdo de certificações de segurança de IA
Para refletir a prática atual, os currículos de certificação precisam cobrir:
- Defesa em profundidade contra injeção de prompt: filtragem de entradas, validação de saídas, escopo de ferramentas, isolamento e aprovação humana, incluindo as limitações documentadas de cada medida
- Verificação da cadeia de suprimentos de modelos: riscos de serialização insegura, requisitos de SBOM, documentação de proveniência e verificação de artefatos assinados
- Arquitetura de segurança de agentes de IA: limites de confiança, acesso mínimo a ferramentas, reversibilidade de ações e requisitos de monitoramento
- Segurança de MCP e integrações externas: avaliação de confiança de servidores de ferramentas, auditoria de permissões e separação entre dados e instruções
- Avaliação e red teaming: como definir o escopo de uma avaliação adversarial, quais benchmarks e datasets existem e como interpretar resultados
- Observabilidade de IA: quais logs e dados de telemetria são necessários e como usá-los para detectar e responder a incidentes
- Resposta a incidentes específica de IA: planejamento prévio, coleta de evidências sobre o comportamento do modelo e recuperação própria de sistemas de IA
- Prevenção de vazamento de dados: isolamento RAG, confidencialidade de prompts, controles de acesso multi-tenant e filtragem de saídas
O que fazer agora
Se você é responsável pelos sistemas de IA da sua organização:
Leia o OWASP Top 10 for Large Language Model Applications e o OWASP Agentic AI Top 10. São gratuitos e oferecem mais detalhes operacionais do que os currículos atuais de certificações pagas.
Revise o MITRE ATLAS antes da próxima sessão de modelagem de ameaças sobre qualquer componente de IA. Saiba quais táticas adversárias se aplicam à sua arquitetura antes de finalizar o projeto de implantação.
Leia o NIST AI 600-1. Ele amplia o AI RMF básico especificamente para IA generativa e é muito mais relevante para implantações de LLMs e agentes do que o framework básico sozinho.
Consulte o Google SAIF, o Microsoft’s AI SDL e o OWASP AI Exchange para obter orientação de engenharia que os frameworks de governança não oferecem.
Verifique a proveniência de cada modelo implantado pela sua organização. Confira os model cards. Antes de carregar os pesos, examine formatos de serialização em busca de classes de exploração conhecidas.
Mapeie cada agente de IA do seu ambiente e os acessos que possui. Um agente com acesso de leitura e escrita à base de conhecimento interna, ao e-mail e ao sistema de arquivos amplia o impacto da injeção de prompt. Reduza suas credenciais ao necessário para cada tarefa.
Exija red teaming específico para IA antes de implantar qualquer modelo ou agente em um contexto de alto impacto. Trate-o como obrigatório.
Crie agora runbooks de resposta a incidentes específicos para IA, antes de precisar deles.
Trate a certificação de governança como documentação da camada de processos. Ela não documenta sua postura de segurança.
Referências
- NIST AI Risk Management Framework (AI RMF 1.0), 2023
- NIST AI 600-1: Generative AI Profile, 2024
- NIST SP 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence
- ISO/IEC 42001:2023 Artificial Intelligence Management Systems
- EU AI Act, Regulation (EU) 2024/1689
- OWASP Top 10 for Large Language Model Applications, 2025
- OWASP Agentic AI Top 10
- OWASP AI Exchange
- MITRE ATLAS: Adversarial Threat Landscape for AI Systems
- Google Secure AI Framework (SAIF)
- Microsoft AI Security SDL documentation
- CISA Guidance on AI Cybersecurity, 2024
- Barreno et al., Can Machine Learning Be Secure?, 2006
- Biggio et al., Poisoning Attacks Against Support Vector Machines, 2012
- Goodfellow et al., Explaining and Harnessing Adversarial Examples, ICLR 2015
- IAPP AI Governance Professional (AIGP) program documentation
- ISACA AI Fundamentals Certificate program documentation
Related Posts