
Claude Cowork e Claude Code com modelos locais: guia de configuração 2026

Table of Contents
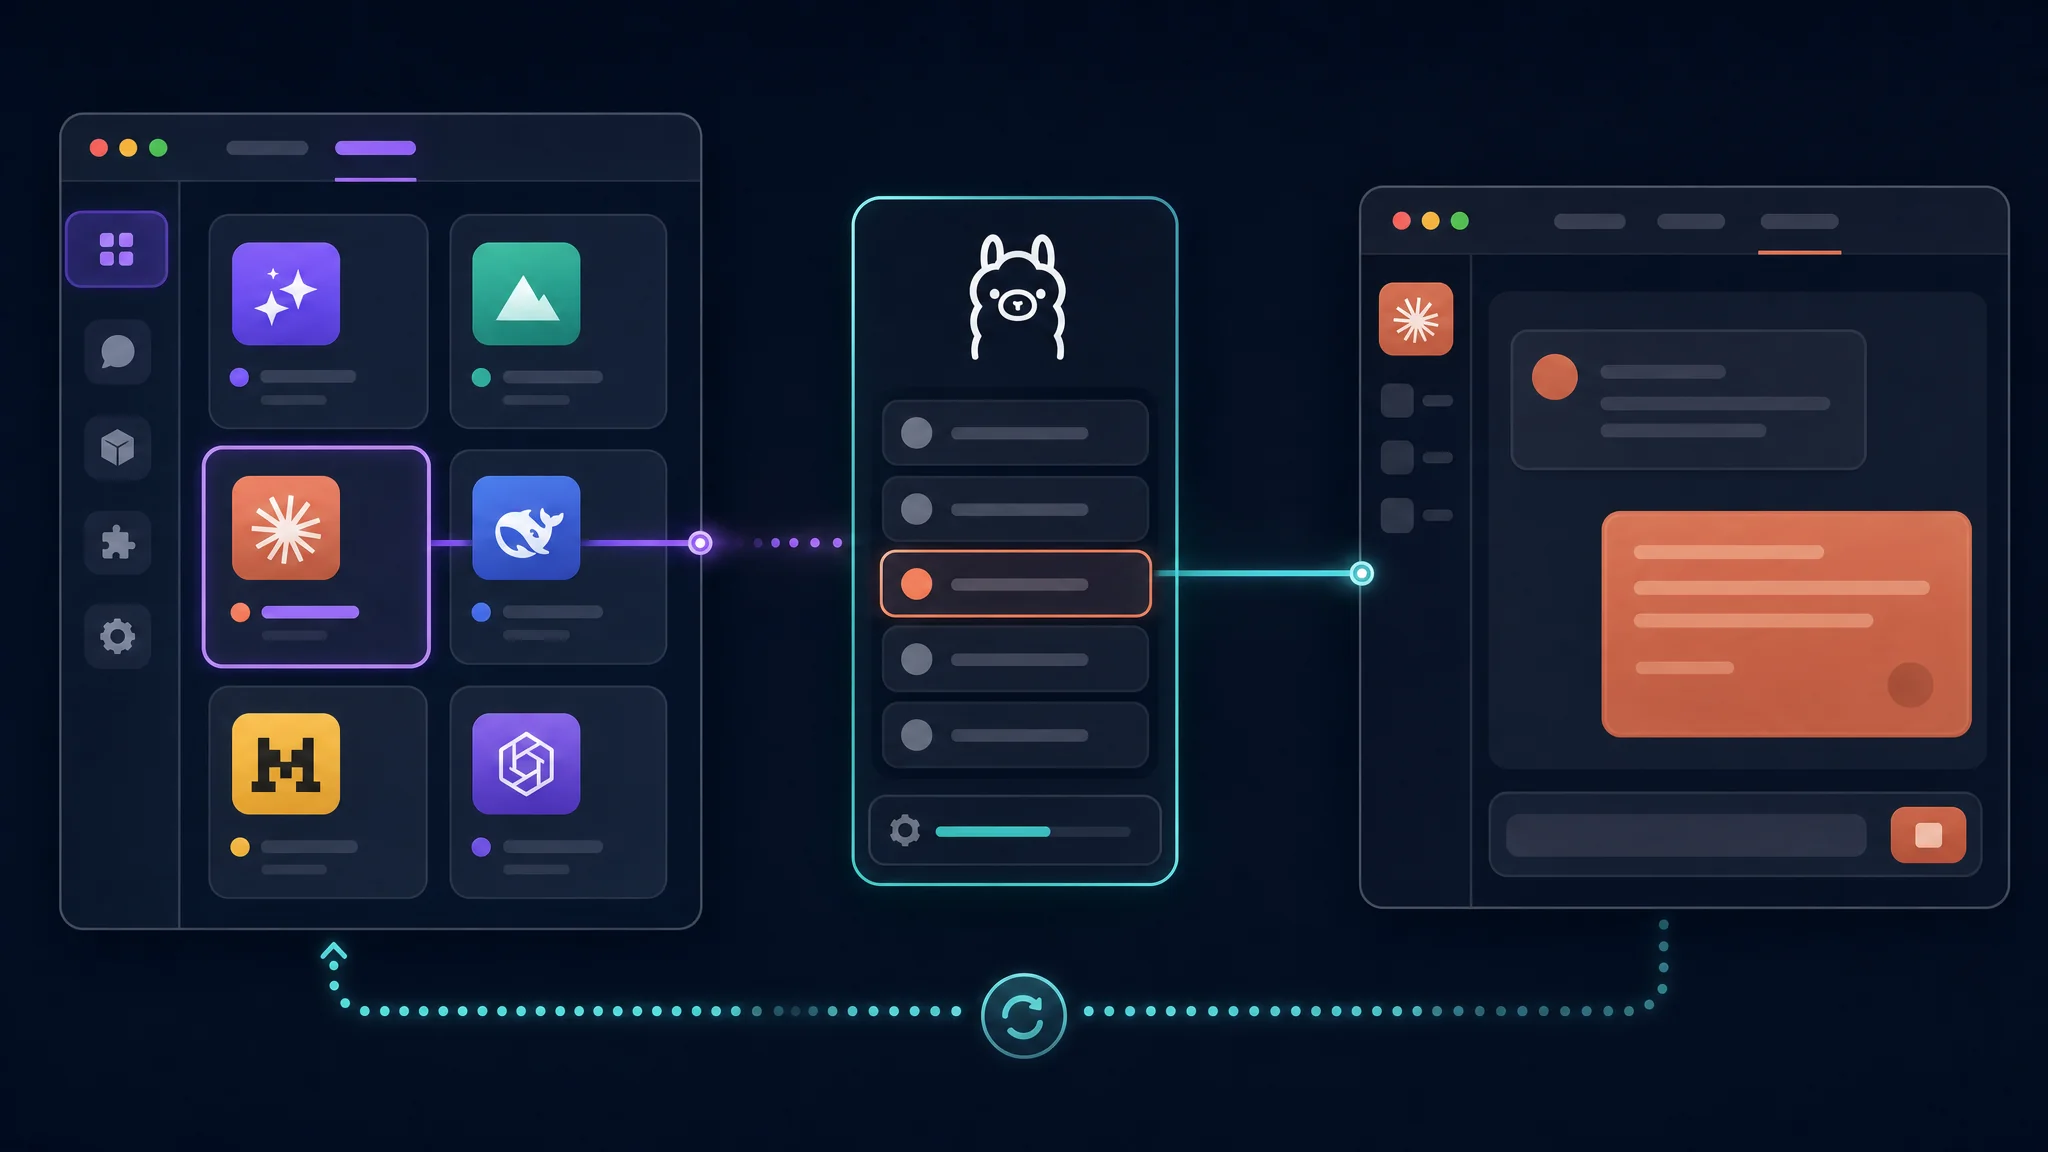
As ferramentas de agente do Claude agora funcionam com modelos no seu próprio hardware, sem chave de API, assinatura ou dados saindo da máquina. O Ollama oferece uma API compatível com Anthropic, e Claude Code e Claude Desktop se conectam a ela com poucos comandos.
Muitos guias deixam passar um detalhe importante. Eles falam do Claude Cowork e depois apresentam etapas que configuram a ferramenta de linha de comando. São duas integrações diferentes, e só uma delas oferece Cowork.
Este guia explica os dois caminhos separadamente, mostra a variável de ambiente ignorada por tutoriais populares, indica modelos apropriados para cada caminho em setembro de 2026 e identifica os recursos que continuam exclusivos da nuvem, qualquer que seja a configuração.
Ao terminar o guia: você identificará a integração de que precisa, conectará pelo caminho documentado do Ollama e verificará o endpoint com um teste de chamada de ferramenta. A inferência local mantém as solicitações ao modelo na máquina somente quando você escolhe um modelo local e evita os recursos baseados na nuvem.
Resposta rápida
O Ollama se conecta ao Claude de duas formas distintas. Escolher a errada é o motivo mais comum para terminar um guia com um terminal funcionando, mas sem Cowork.
| Integração | O que oferece | Caminho de configuração | Plataforma |
|---|---|---|---|
| Claude Desktop | Cowork, subagentes, pesquisa na web, modo automático | Aplicativo Ollama, depois Apps e Connect Claude | Somente macOS |
| Claude Code | Agente de programação CLI com chamadas de ferramentas e edição de arquivos | ollama launch claude ou variáveis de ambiente | macOS, Linux, Windows |
Se você quer Cowork, use a integração do Claude Desktop. Ela funciona pela interface gráfica do aplicativo Ollama e só está disponível no macOS. O suporte ao Windows continua listado como futuro.
Se você quer um agente no terminal, use Claude Code. Um comando basta.
Os dois são gratuitos. Os custos se limitam ao hardware e à eletricidade.
Duas integrações diferentes
A confusão começa pelos nomes. Claude Cowork é um recurso dentro do Claude Desktop, não um aplicativo separado nem outro nome para Claude Code.
A documentação do Ollama lista as integrações em páginas e seções separadas. Claude Desktop aparece em Assistants, ao lado de OpenClaw e Hermes. Claude Code aparece em Coding, junto com OpenCode, Cline e Codex CLI.
Essa diferença importa porque a configuração muda completamente:
- Claude Desktop é configurado pela interface do aplicativo Ollama. Você não precisa alterar um perfil de shell.
- Claude Code é configurado por variáveis de ambiente ou por um comando de inicialização.
Um guia que pede para exportar ANTHROPIC_BASE_URL e executar claude configurou a ferramenta de linha de comando. Se você esperava a experiência desktop do Cowork, nada está quebrado na configuração. Você configurou outro produto.
Configurar Claude Desktop e Cowork
Este caminho passa pelo aplicativo Ollama, não pelo terminal.
Pré-requisitos
- Ollama instalado no macOS. O suporte ao Windows aparece como futuro.
- Um modelo baixado antes para execução local. Para um modelo na nuvem, entre no Ollama e habilite os modelos cloud. Alguns exigem um plano pago.
- Claude instalado. Se não estiver, o Ollama oferece o download durante a configuração.
Etapas
- Abra o Ollama e selecione Apps.
- Selecione Connect Claude.
- Siga as instruções. Instale Claude se solicitado e reinicie-o quando pedido.
Esse é o processo completo. Para mudar de modelo depois, abra Ollama Settings, acesse Apps, escolha os modelos e selecione Restart Claude.
Recursos disponíveis
A documentação do Ollama lista quatro recursos como compatíveis com essa integração:
- Cowork, para concluir tarefas difíceis
- Subagentes, para dividir tarefas maiores entre agentes
- Web search, fornecida por padrão pelo Ollama
- Auto mode, que permite ao agente decidir quando pedir autorização antes de fazer alterações
Cowork aparece na lista. Ele funciona por essa integração, mas não pela integração de linha de comando.
Desconectar
Desconectar restaura a configuração anterior do Claude, portanto a alteração não é destrutiva.
- Pela interface, abra Apps, desconecte Claude e reinicie-o quando solicitado.
- No terminal, execute
ollama launch claude-desktop --restore. - Fechar o Ollama enquanto Claude está conectado também restaura a configuração habitual do Claude. Deixe o Ollama aberto se quiser manter a configuração local.
Configurar Claude Code pela CLI
Quase todos os guias cobrem esse caminho, que é o correto para trabalhar no terminal.
Método de um comando
ollama launch claude
O comando define as variáveis de ambiente necessárias, aponta Claude Code para sua instância local do Ollama e inicia o programa. Escolha um modelo da lista e pressione Enter. Para indicar o modelo antecipadamente, acrescente a opção:
ollama launch claude --model qwen3.5
O wrapper prepara o ambiente. Leia a próxima seção mesmo assim, pois saber o que ele define ajuda na solução de problemas.
Definir variáveis de ambiente manualmente
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434

claude --model qwen3.5
A segunda linha é a que falta em muitos guias populares. Definir ANTHROPIC_API_KEY como uma string vazia impede que uma chave real já presente no ambiente interfira na conexão local. Se um guia publicado omitir essa linha, leitores que já exportaram uma chave receberão um erro confuso.
Para não alterar o perfil do shell, passe tudo diretamente no comando:
ANTHROPIC_AUTH_TOKEN=ollama ANTHROPIC_BASE_URL=http://localhost:11434 ANTHROPIC_API_KEY="" claude --model kimi-k2.7-code:cloud
Dois detalhes da documentação oficial:
ANTHROPIC_AUTH_TOKENcontém a autenticação bearer, por isso seu valor literal no modo local éollama.- Os arquivos de configuração do Claude têm prioridade sobre as variáveis do shell. Se a conexão se comportar de modo estranho depois de exportar valores novos, confira as configurações e execute
/statusno Claude Code para ver qual endpoint está em uso.
Conectar diretamente ao Ollama Cloud
Você não precisa instalar o Ollama para esse caminho. Defina uma chave de API e aponte Claude Code para o endpoint hospedado pelo Ollama:
ANTHROPIC_BASE_URL=https://ollama.com \
ANTHROPIC_AUTH_TOKEN="$OLLAMA_API_KEY" \
ANTHROPIC_API_KEY="" \
claude --model glm-5.3-flash
Esse caminho tem uma limitação. A documentação do Ollama informa que a pesquisa web hospedada e os controles avançados de ferramentas não são totalmente compatíveis. Chat básico, edição de arquivos e chamadas de ferramentas funcionam com modelos compatíveis.
Modelos para setembro de 2026
A lista de modelos mudou bastante em 2026. Vale revisar as recomendações publicadas na primavera.
| Modelo | Tipo | Contexto | Por que escolher |
|---|---|---|---|
| Qwen3.8 27B | Local, 18 GB | 256K | Melhor modelo local versátil atual, com visão, chamadas de ferramentas e controle de pensamento |
| Qwen3 Coder Next | Local, MoE 80B total / 3B ativos | 256K | Feito para agentes de programação sempre ativos, com modo sem pensamento para maior velocidade |
| Qwen3.6 35B A3B | Local, MoE 35B / 3B ativos | 262K | Apache 2.0 e eficiente com pouca memória |
| kimi-k2.7-code:cloud | Nuvem | Grande | Modelo na nuvem focado em programação, sem requisito de hardware local |
| glm-5.3-flash | Nuvem | Grande | Primeiro modelo recomendado pela documentação do próprio Ollama |
Comece com Qwen3.8 27B se tiver memória suficiente. Ele roda localmente com janela de contexto 256K, visão nativa, chamadas de ferramentas e pensamento que pode ser ativado por solicitação. Uma placa com pelo menos 24 GB oferece uso diário confortável.
Comece com um modelo na nuvem se não tiver essa memória. Testar Claude Code com um modelo hospedado não custa nada e elimina a questão do hardware, mas seu código sai da máquina.
Aviso sobre modelos ternários
Em nosso guia de IA local , mostramos que o Bonsai 2 27B ternário roda um modelo completo de 27B em 5,53 GiB. É tentador usar a mesma opção aqui.
Ele não funciona nesse fluxo de trabalho. Os kernels ternários ficam no fork do llama.cpp da Prism ML, e o Ollama padrão não carrega esses arquivos. Um comando como ollama launch claude --model Ternary-Bonsai-2-27B falha antes de iniciar a inferência. Use o pacote padrão Qwen3.8 27B com Claude Code e reserve os pacotes ternários para um runtime compatível.
Conveniência e eficiência máxima apontam para escolhas diferentes. As ferramentas integradas esperam um GGUF padrão.
Defina um contexto de 64K antes de culpar o modelo
A documentação do Ollama dá uma instrução direta para trabalhar com repositórios: escolha um modelo e defina uma janela de contexto de pelo menos 64K, aumentando-a para repositórios maiores.
Claude Code carrega o conteúdo dos arquivos, diffs e saída dos comandos na janela de contexto. Se o valor padrão for pequeno, o espaço acaba no meio da tarefa. A falha parece um problema de raciocínio, mas vem da configuração.
| Contexto | O que atende |
|---|---|
| Menos de 32K | Edição de arquivo único e perguntas rápidas |
| 64K | Trabalho com vários arquivos em um repositório modesto |
| 128K | Repositórios maiores e saída longa de comandos |
| 256K | Janela completa do Qwen3.8 27B |
Se Claude Code perder o fio no meio da tarefa, confira o contexto antes de trocar de modelo.
Verificar chamadas de ferramentas com um comando
Chamadas de ferramentas distinguem um agente de um gerador de texto. Confirme que funcionam.
Depois de iniciar Claude Code, peça:
Read the current directory and list all files
Se listar arquivos reais, as chamadas de ferramentas funcionam. Se responder que leria o diretório e descrever o que espera encontrar, o recurso não está conectado. Você está usando um modelo de chat com um prompt de programação, não um agente. Mais prompts não corrigem isso.
Verifique as causas nesta ordem:
- Troque para um modelo com suporte confirmado a ferramentas. Nem todo modelo oferece esse suporte e a contagem de parâmetros não mostra a diferença.
- Confirme que o ambiente aponta para o Ollama. Execute
ollama --versione confira seANTHROPIC_BASE_URLindica o endpoint local. - Execute
/statusno Claude Code. Uma URL base ou credencial nos arquivos de configuração do Claude prevalece sobre as variáveis do shell recém-exportadas.
O que continua exclusivo da nuvem
Conheça o limite antes de reconstruir um fluxo de trabalho em torno da inferência local.
| Recurso | Com modelos locais | Nuvem |
|---|---|---|
| Chat e edição de arquivos | Sim | Sim |
| Chamadas de ferramentas | Depende do modelo | Sim |
| Subagentes | Sim | Sim |
| Pesquisa na web | Fornecida pelo Ollama | Sim |
| Cowork | Pela integração Claude Desktop | Sim |
| Modo automático | Pela integração Claude Desktop | Sim |
| Prompts agendados | Por /loop no Claude Code | Sim |
Há três limitações no uso local:
- O raciocínio com vários arquivos piora antes da velocidade. Um modelo local lida bem com um arquivo, razoavelmente com três e mal com um repositório inteiro. Ajuste o tamanho da tarefa.
- Alguns modelos na nuvem exigem um plano pago do Ollama. Também é necessário entrar na conta e habilitá-los.
- O caminho direto pela nuvem limita alguns recursos. Sem a instalação local, a pesquisa web hospedada e os controles avançados de ferramentas não têm suporte completo.
A inferência local funciona bem para tarefas delimitadas e verificáveis, e pior para trabalhos amplos e ambíguos. Planeje considerando esse limite.
Automatizar
Dois recursos permitem ir além do uso interativo.
Execução headless para scripts e CI
A opção --yes ignora seletores interativos e baixa o modelo quando necessário. Ela exige --model, e tudo depois de -- segue diretamente para Claude Code:
ollama launch claude --model gemma4:cloud --yes -- -p "how does this repository work?"
Observe o modelo de permissões. Claude Code pede confirmação antes da maioria das ações. Uma execução headless precisa de regras de permissão configuradas ou de um ambiente isolado. Não direcione um agente sem supervisão a um repositório importante para você.
Prompts agendados com /loop
Dentro de uma sessão do Claude Code, /loop executa um prompt ou comando slash em intervalos definidos:
/loop 30m Check my open PRs and summarize their status
/loop 1h Research the latest AI news and summarize key developments
/loop 15m Check for new GitHub issues and triage by priority
Isso funciona enquanto a sessão está aberta. Não é um daemon de segundo plano e termina quando a sessão termina.
Solução de problemas
| Sintoma | Causa provável | Solução |
|---|---|---|
| Conexão recusada | Ollama não está em execução | Execute ollama serve e confirme com curl http://localhost:11434/api/tags |
| Descreve ações em vez de executá-las | O modelo escolhido não oferece chamadas de ferramentas | Troque para um modelo com suporte confirmado |
| Uma chave de API real é usada em vez do endpoint local | ANTHROPIC_API_KEY ainda está exportada | Defina uma string vazia, como mostrado acima |
| Cowork não aparece depois da configuração | A CLI do Claude Code foi configurada no lugar do Claude Desktop | Use o fluxo Apps do Ollama para Cowork |
| Geração lenta | Contexto alto demais ou modelo denso escolhido quando um esparso bastaria | Reduza o contexto e tente um modelo mixture-of-experts |
| As variáveis exportadas não têm efeito | Arquivos de configuração do Claude têm prioridade sobre variáveis do shell | Confira os arquivos e execute /status |
| Solicitações em segundo plano falham | Claude Code escolhe um modelo pequeno para tarefas internas | Aponte a substituição do modelo pequeno para o mesmo modelo local |
Dois desses sete problemas têm a mesma causa. A maioria dos erros de configuração vem de um endpoint incorreto ou de um modelo sem chamadas de ferramentas.
Principais pontos
- Claude Desktop e Claude Code são integrações distintas. Cowork fica no Claude Desktop e é configurado no macOS pelo painel Apps do Ollama. O caminho CLI não oferece Cowork.
- Um comando inicia o caminho CLI:
ollama launch claude. A configuração manual precisa de três variáveis, e muitos guias deixamANTHROPIC_API_KEY=""de fora. - A instalação local não é obrigatória. Aponte Claude Code para
https://ollama.comusando uma chave de API. - Defina contexto de pelo menos 64K antes de avaliar o modelo. Uma janela pequena pode parecer uma falha de raciocínio.
- Verifique chamadas de ferramentas com uma solicitação. Se o modelo descreve o que faria, você tem um gerador de texto, não um agente.
- Pacotes Bonsai ternários não funcionam aqui. Eles exigem o fork do llama.cpp da Prism ML, que o Ollama padrão não carrega.
- Desconectar é seguro. Fechar o Ollama restaura a configuração anterior do Claude. Também dá para executar
ollama launch claude-desktop --restoreno terminal.
Próximos passos
- Instale o Ollama e baixe um modelo com suporte confirmado a ferramentas antes de configurar Claude: Biblioteca de modelos do Ollama
- Leia a página do Ollama sobre Claude Code para conferir flags e modelos atuais: Integração Claude Code
- Use a página do Claude Desktop se quiser Cowork: Integração Claude Desktop
- Dimensione o hardware antes da compra, usando as faixas de memória do nosso guia de inferência local: IA local em 2026: modelo 27B supera Sonnet 4.6
- Confira o que um hardware menor suporta se quiser um agente sempre ativo em um equipamento econômico: Quais modelos de IA rodam em um Raspberry Pi 4 ou 5?
Artigos relacionados
| Artigo | Conteúdo |
|---|---|
| IA local em 2026: modelo 27B supera Sonnet 4.6 | Benchmark de inferência local, quantização ternária e escolha de hardware |
| Quais modelos de IA rodam em um Raspberry Pi 4 ou 5? | Inferência local para um assistente pequeno sempre ativo |
| Criar um assistente de IA que preserva a privacidade para Meshtastic | Modelo local controlando um rádio offline, com a privacidade como prioridade |
| Melhores extensões do VS Code para desenvolvimento de IA | Ferramentas de editor para combinar com um agente local de programação |
Referências
- Integração Claude Code - documentação do Ollama
- Integração Claude Desktop - documentação do Ollama
- Biblioteca de modelos do Ollama
- Qwen3.8 - biblioteca de modelos do Ollama
- Claude Cowork com modelos locais - PromptSpace
- Fork do llama.cpp da Prism ML - kernels ternários
Related Posts
This article refers to other articles we've written:
- IA local em 2026: modelo 27B supera Sonnet 4.6 enquanto a janela para comprar equipamentos se fecha
Planeje um PC de IA local para 2026 considerando tamanho do modelo, VRAM, largura de banda da memória, energia, custo e opções de atualização.
- Quais modelos de IA funcionam num Raspberry Pi 4 ou 5?
Use medições no Raspberry Pi 4 e 5 para escolher modelos de linguagem locais por memória, velocidade e carga de trabalho, dos pequenos LFM2.5 às opções 3B e maiores.
