

Em 2026, contêineres deixaram de ser uma fronteira de segurança

Table of Contents
Os contêineres compartilham um único kernel. Em 2026, quatro famílias de vulnerabilidades distintas provaram que um único bug no kernel basta para sair de um contêiner e chegar ao host. Copy Fail, Dirty Frag, Fragnesia e CVE-2026-80521 dão privilégios root a um usuário local sem privilégios. Todas atravessam a fronteira do contêiner.
O aspecto preocupante não são os bugs em si. É o baixo custo com que a IA os encontra agora e como um patch criou outro bug.
Este artigo explica como os contêineres isolam cargas de trabalho, por que esse isolamento agora se apoia em uma base cada vez menor, o que cada vulnerabilidade de 2026 faz e em qual tecnologia de isolamento confiar no lugar dos contêineres.
O que você vai levar: mapeie quem fornece o código de cada carga de trabalho, identifique os recursos do kernel de que ela precisa e escolha entre contêineres reforçados e uma fronteira de microVM. Trate os estudos de caso de 2026 como evidências de pesquisa datadas. Consulte os avisos atuais dos fornecedores antes de alterar um kernel de produção.
Resposta curta
| Pergunta | Resposta curta |
|---|---|
| Os contêineres isolam? | Sim, no nível de processos e sistema de arquivos. Todos compartilham um kernel, então falhas no kernel representam um risco compartilhado |
| Por que agora? | A busca por bugs assistida por IA reduziu o custo de encontrar falhas no kernel. Até setembro de 2026, quase 6.000 CVEs do kernel haviam sido publicadas |
| O que rompe a fronteira? | Qualquer escalonamento local de privilégios no kernel. Não é preciso configurar o contêiner incorretamente para escapar |
| Aplicar patches basta? | É necessário, mas a velocidade já não acompanha as descobertas. Um patch de 2026 introduziu um novo bug explorável |
| O que funciona melhor? | MicroVMs como Firecracker ou Kata Containers, que dão a cada carga de trabalho seu próprio kernel |
| A alternativa é perfeita? | Não. O hipervisor também é código. A superfície de ataque é muito menor, e essa diferença é o ponto principal |
Como os contêineres isolam
Para entender a fronteira, primeiro é importante saber o que um contêiner não é.
Um contêiner não é uma máquina virtual. Não há um segundo kernel, hardware emulado ou hipervisor entre o processo e o hardware. Ao executar uma imagem de contêiner, você executa um processo no kernel existente, com uma visão modificada do sistema.
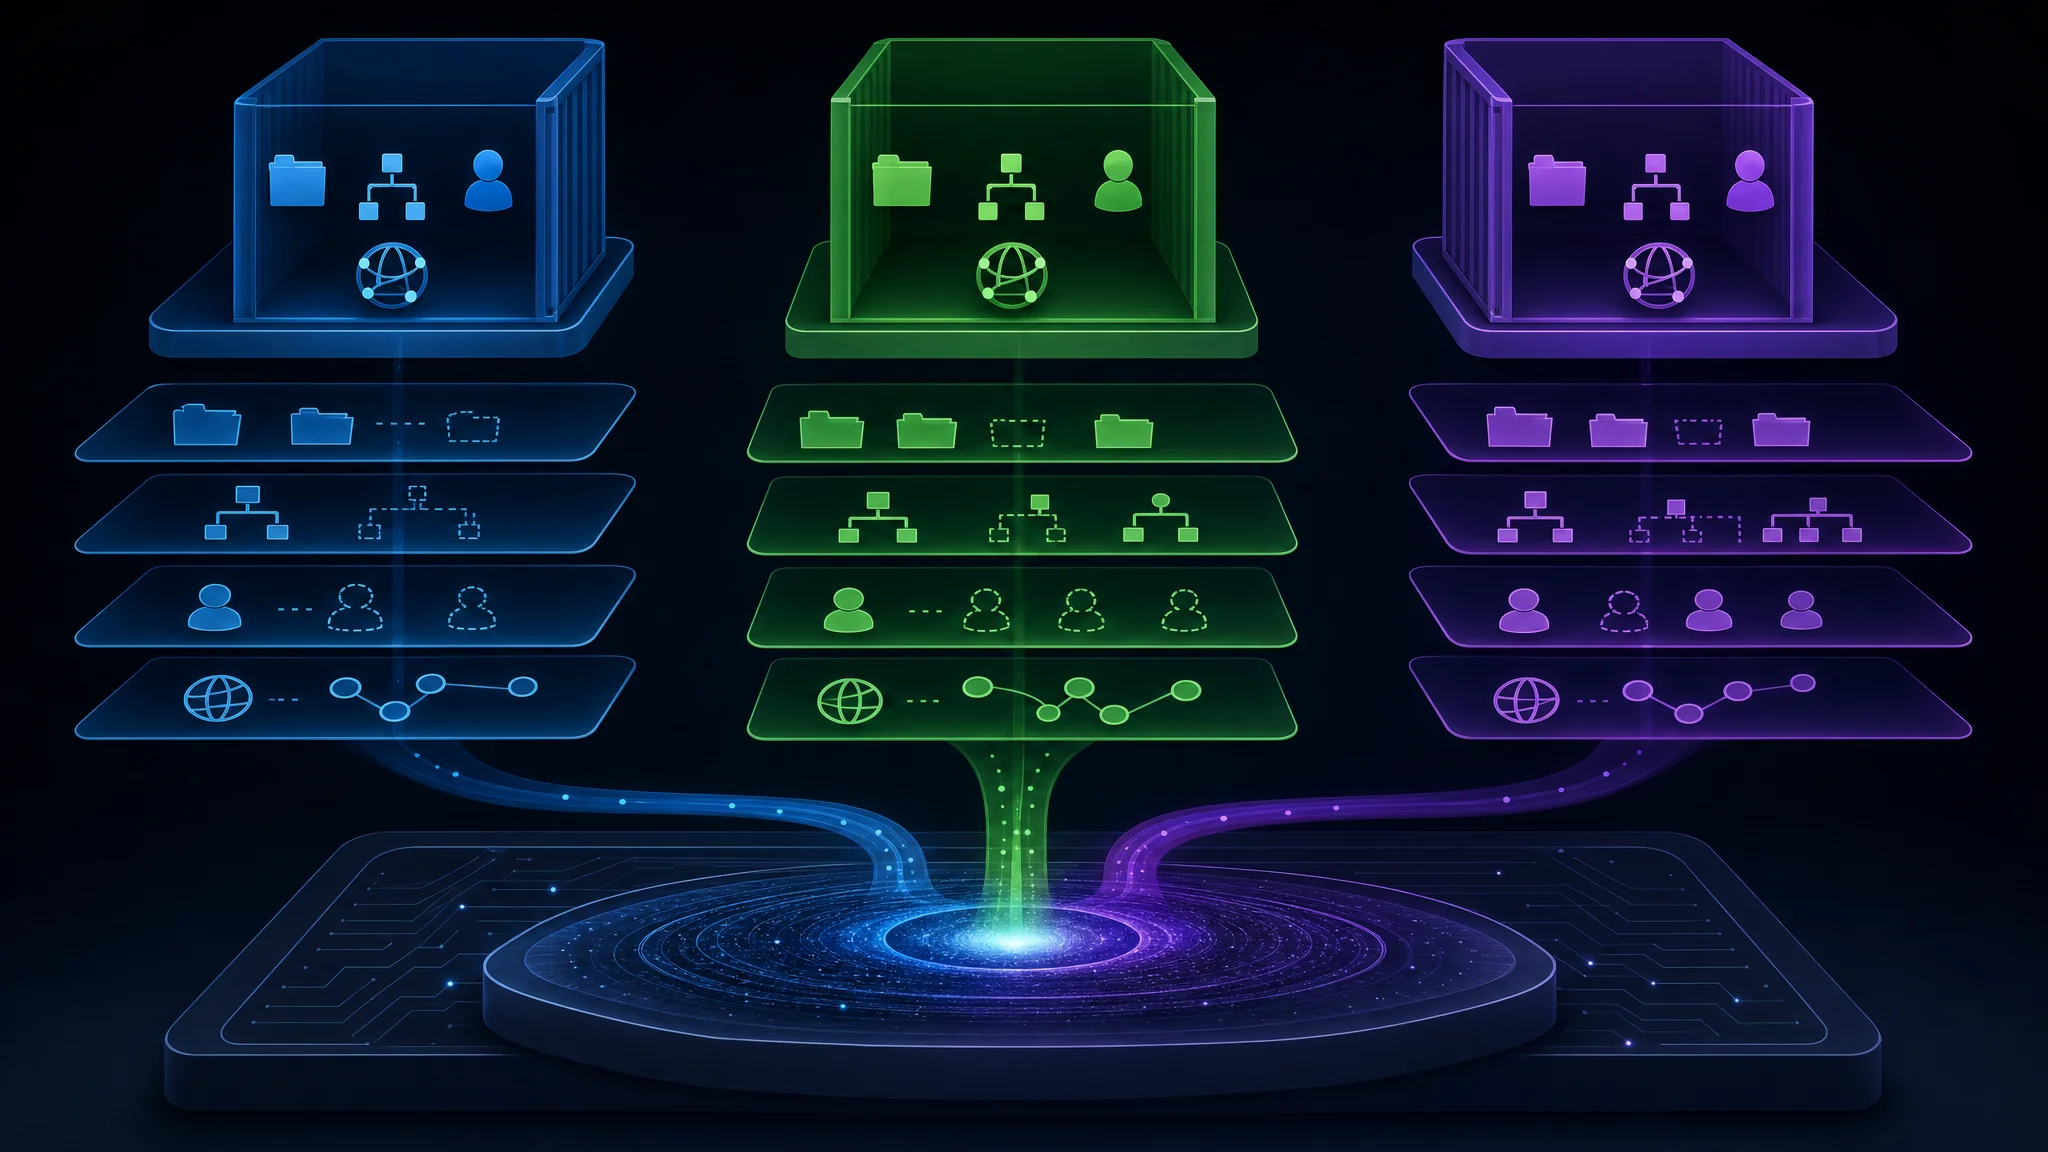
O mecanismo é a chamada de sistema clone. fork copia o espaço de endereçamento de um processo; clone cria um processo filho e permite controlar com precisão quais partes do contexto de execução são compartilhadas ou substituídas. O Docker passa a clone um conjunto de namespaces:
| Namespace | O que simula |
|---|---|
| Mount | Uma raiz privada do sistema de arquivos, para que o contêiner veja sua própria árvore em vez da sua |
| PID | Numeração própria de processos, de modo que PID 1 seja o primeiro processo do contêiner, não o systemd |
| User | Um mapeamento de identidade em que “root” no contêiner corresponde a um usuário sem privilégios no host |
| Network | Interfaces, tabelas de roteamento e portas privadas |
| IPC | Memória compartilhada e filas de mensagens isoladas |
| UTS | Nome de host e domínio próprios |
| Cgroup | Uma visão privada dos limites de recursos |
Adicione um sistema de arquivos union sobre uma imagem e o resultado parece um computador separado. id mostra uid=0(root) dentro do contêiner. O sistema de arquivos parece uma instalação mínima do Ubuntu. A lista de processos mostra somente os processos dele.
No nível das chamadas de sistema, isso não é uma fronteira de segurança. Quando um processo no contêiner abre um arquivo, aloca memória ou usa um socket de rede, o mesmo kernel processa a solicitação para todos os outros contêineres do host. Namespaces mudam o que o processo vê, não o que o kernel fará por ele.
O kernel é a fronteira real entre o contêiner e o host. O restante é apresentação.
A fronteira é código, e código contém bugs
Toda ação de um contêiner passa pela interface de chamadas de sistema. Abrir um arquivo, ler memória, escrever em um socket, alterar um UID: o kernel intermedia tudo isso porque não quer que os processos acessem diretamente a CPU, o sistema de arquivos ou a rede.
Essa intermediação é o modelo de segurança, e ela é implementada em código. Mais precisamente, são cerca de 30 milhões de linhas.
Um escalonamento local de privilégios (LPE) ocorre quando um processo explora uma falha no código de intermediação para obter privilégios que nunca recebeu. LPEs não são novidade. Existem desde os primeiros mecanismos de intermediação do kernel. Durante décadas, o setor conviveu com um fluxo constante delas.
Dirty Pipe, em 2022, é o exemplo de referência que a maioria conhece. Ela explorou uma falha no tratamento de buffers de pipe para sobrescrever arquivos somente leitura. Virou notícia porque bugs dessa gravidade apareciam aproximadamente a cada um ou dois anos. Você aplicava o patch e seguia em frente, supondo que nenhum defeito grande passava despercebido em um código lido por um milhão de pessoas.
Essa suposição não vale mais.
O que mudou em 2026
A mudança não está na habilidade dos atacantes. Está no fato de que encontrar bugs de corrupção de memória no kernel virou uma tarefa de engenharia, não uma carreira de pesquisa.
Três dados deste ano deixam a mudança concreta:
| Descoberta | Quem encontrou | Como |
|---|---|---|
| Copy Fail (CVE-2026-31431) | Taeyang Lee, Theori | Com auxílio do Xint Code, ferramenta de análise estática com IA. Cerca de uma hora de varredura no subsistema criptográfico do Linux |
| CVE-2026-80521 | Zhenpeng (Leo) Lin, DepthFirst | Encontrada com dfs-large1, modelo de IA interno treinado para detectar vulnerabilidades |
| CVE-2026-80521, descoberta independentemente | Kyle, OpenAI | O mesmo bug, encontrado separadamente e relatado no mesmo dia |
Leia a terceira linha novamente. Duas organizações que usaram ferramentas de IA diferentes encontraram o mesmo use-after-free no AF_UNIX e o relataram a [email protected] no mesmo dia. Não foi coincidência de talento. Foi um processo repetível que produziu a mesma resposta duas vezes.
A DepthFirst indica diretamente a escala: quase 6.000 CVEs do kernel haviam sido publicadas até setembro de 2026. A contagem cresce com a disponibilidade de assistência de IA, não com o número de desenvolvedores do kernel.
Quando uma hora de varredura por IA encontra um bug de uma década no subsistema criptográfico, a economia da exploração do kernel se inverte.
Quatro escapes em um ano
Cada uma dessas vulnerabilidades dá root a uma conta local sem privilégios. Nenhuma exige configuração incorreta do contêiner, flag privilegiada ou acesso inicial pela rede.
| Vulnerabilidade | CVE | Subsistema | Primitiva | Descoberta por |
|---|---|---|---|---|
| Copy Fail | CVE-2026-31431 | algif_aead / AF_ALG | Escrita de 4 bytes no cache de páginas de qualquer arquivo legível | Theori, com auxílio de IA |
| Dirty Frag | CVE-2026-43284 + CVE-2026-43500 | XFRM ESP, RxRPC | Escrita de 4 bytes no cache de páginas por duas variantes encadeadas | Hyunwoo Kim |
| Fragnesia | CVE-2026-46300 | XFRM ESP-in-TCP | Escritas de um byte no cache de páginas | Hyunwoo Kim |
| AF_UNIX UAF | CVE-2026-80521 | Sockets AF_UNIX | Use-after-free na coleta de lixo de unix_vertex | DepthFirst, com auxílio de IA |
As quatro compartilham um padrão de projeto importante: atacam o cache de páginas, não o disco.
Copy Fail: falha lógica sem corrida
Copy Fail é a mais simples das quatro e a mais alarmante.
Quase todo LPE no Linux precisa de uma janela de tempo ou de um deslocamento de memória específico do kernel. Copy Fail não precisa de nenhum dos dois. É uma falha lógica direta em algif_aead, o módulo que fornece ao espaço de usuário acesso à criptografia autenticada por meio de AF_ALG.
A cadeia usa splice() para inserir uma página do cache de páginas na operação e depois abusa do caminho AEAD no próprio local para gravar quatro bytes controlados nessa página. A página corrompida nunca é marcada como dirty, por isso nunca volta ao disco. O arquivo em disco continua intacto, então as verificações de checksum e integridade passam mesmo que a cópia na memória tenha sido alterada.
Um script Python de 732 bytes obtém root em todas as distribuições Linux lançadas desde 2017. O bug foi introduzido por uma otimização de 2017 em algif_aead, e o patch de 2026 simplesmente reverte a otimização. Commit mainline a664bf3d603d.
O bug permaneceu em todas as principais distribuições por quase uma década, e uma ferramenta de IA o encontrou em cerca de uma hora.
Dirty Frag: duas variantes que se complementam
O nome Dirty Frag descreve bem sua linhagem: Dirty Pipe sobrescreve struct pipe_buffer. Dirty Frag sobrescreve o campo frag de struct sk_buff.
São duas vulnerabilidades encadeadas, e o encadeamento é a parte engenhosa:
- CVE-2026-43284 explora
esp_input()ignorando o caminho copy-on-write antes de executar a descriptografia no próprio local em um fragmento inserido com splice. Exige o privilégio de criar um user namespace, restrito em algumas distribuições. - CVE-2026-43500 explora
rxkad_verify_packet_1()para descriptografar o fragmento no próprio local. Não exige privilégio de namespace, mas o módulorxrpcnão está presente na maioria das distribuições. O Ubuntu o carrega por padrão.
Cada variante isolada tem um ponto cego. Juntas, elas se complementam. Quando user namespaces são permitidos, o caminho ESP funciona primeiro. Quando estão bloqueados, mas rxrpc está presente, o caminho RxRPC funciona. Um único binário de exploit passa a funcionar em várias distribuições, e a variante RxRPC obtém root limpando um campo em /etc/passwd e deixando o PAM aceitar uma senha vazia com nullok.
A descoberta mais importante para os defensores: Dirty Frag é acionada com ou sem algif_aead. A mitigação de Copy Fail amplamente divulgada, que bloqueia o módulo, não protege contra Dirty Frag em absoluto.
Fragnesia: o patch que criou um bug
Fragnesia pertence à mesma classe que Dirty Frag, mas atinge o caminho ESP-in-TCP do XFRM. É o caso mais instrutivo do conjunto.
A vulnerabilidade explora o tratamento incorreto de fragmentos de página compartilhados durante a coalescência de skb. O atacante insere páginas respaldadas por arquivo na fila de recepção TCP antes de o socket mudar para o modo de protocolo de camada superior espintcp. Quando o processamento ESP é ativado, o kernel descriptografa os dados enfileirados no próprio local, e a manipulação do fluxo de chaves AES-GCM corrompe o cache de páginas subjacente. O atacante obtém gravações repetidas de um byte em páginas de arquivos em cache.
O exploit obtém root sobrescrevendo os primeiros bytes de /usr/bin/su com um pequeno payload ELF. A alteração fica apenas na memória e nunca toca o binário no disco.
User e network namespaces sem privilégios fornecem CAP_NET_ADMIN dentro de um namespace isolado. Em seguida, NETLINK_XFRM instala uma associação de segurança preparada.
Vale refletir sobre esta frase: Fragnesia surgiu como efeito colateral não intencional de um dos patches das vulnerabilidades originais Dirty Frag. Corrigir Dirty Frag criou um novo bug independente que também permite obter root.
CVE-2026-80521: o escape de contêiner que venceu o kernelCTF
A corrida do AF_UNIX acaba com qualquer argumento de que o problema é teórico.
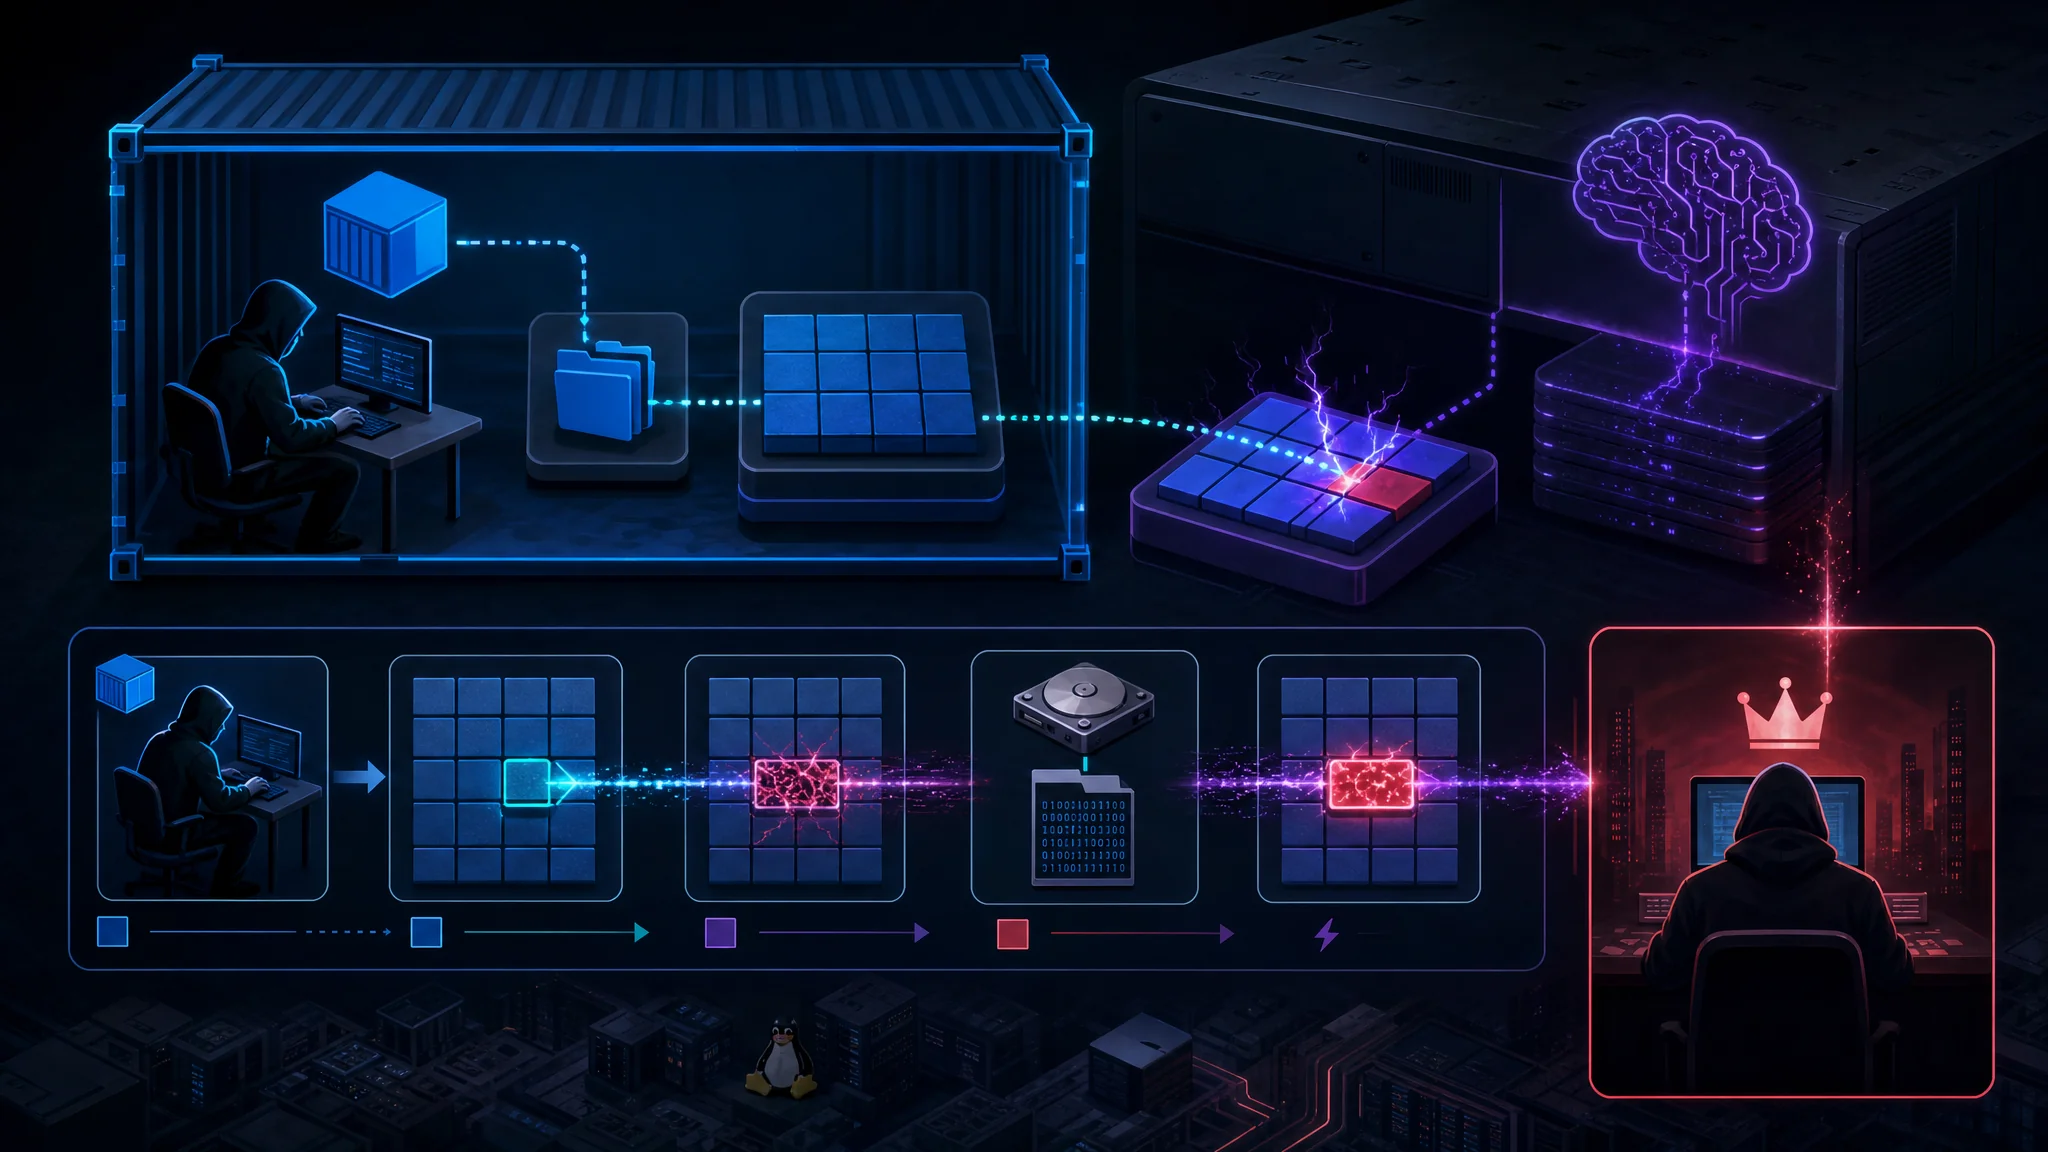
A vulnerabilidade é um use-after-free no heap do mecanismo de coleta de lixo de mensagens SCM_RIGHTS, usado por processos para passar descritores de arquivos entre si. Uma corrida durante a coleta de uma referência circular de socket libera um struct unix_vertex enquanto o anel SCC de um socket sobrevivente ainda mantém um ponteiro para ele. A próxima coleta percorre o anel obsoleto e acessa memória liberada.
Sua importância vai além do Linux, porque AF_UNIX sustenta a comunicação IPC local. Bancos de dados locais, systemd e o próprio Docker dependem dele. A DepthFirst informa que a vulnerabilidade afeta a maioria dos sandboxes de sistema operacional baseados no kernel, incluindo nsjail, Firejail e Bubblewrap, além de runtimes modernos de contêineres.
A DepthFirst venceu uma vaga no Google kernelCTF com a vulnerabilidade em 24 de julho de 2026, recebeu a confirmação no slot lts-6.12.95 em 5 de agosto, relatou-a a [email protected] no mesmo dia e soube que Kyle, da OpenAI, havia relatado o mesmo bug. O patch upstream chegou em 6 de agosto. A pesquisa foi publicada em 22 de setembro.
A equipe lançou um exploit funcional para Ubuntu 26.04 e outro exploit da CVE-2026-52910 que escapa do Ubuntu 24.04.
Por que as orientações de mitigação continuam falhando
Os defensores receberam três rodadas de soluções alternativas neste ano, e cada uma estava parcialmente errada.
| Mitigação | O que impede | O que deixa passar |
|---|---|---|
Colocar algif_aead na lista de bloqueio | Copy Fail | Nada em Dirty Frag, que ignora totalmente o módulo |
Bloquear esp4, esp6, rxrpc | Dirty Frag, Fragnesia | Equipes que precisam de IPsec. Também deixa de fora subsistemas completamente novos |
| Restringir user namespaces sem privilégios | As variantes ESP | A variante RxRPC não precisa de namespace. A política do AppArmor é apenas uma mitigação parcial |
| Aplicar patch no kernel | O bug corrigido | O próximo bug e qualquer bug introduzido pelo patch |
Dois padrões se destacam.
Primeiro, as soluções alternativas entram em conflito. Copy Fail é mitigada ao desativar algif_aead. Dirty Frag é acionada com ou sem o módulo. Fragnesia exige que esp4 e esp6 sejam desativados, o que é um problema para quem usa IPsec. Não há uma única lista de bloqueio de módulos que cubra toda a família.
Segundo, e pior, aplicar um patch não é uma vitória sem riscos. Fragnesia foi introduzida pelo patch de Dirty Frag. Todo patch pode criar novos erros lógicos, e nesse subsistema um erro lógico vira um exploit que obtém root.
A conclusão incômoda: todas essas vulnerabilidades estão no cache de páginas, são acessíveis a partir de código sem privilégios e foram encontradas por ferramentas que melhoram a cada trimestre. Nenhuma lista de bloqueio permanece completa.
A resposta honesta ao contra-argumento
Há uma objeção legítima que merece uma resposta direta: hipervisores também têm bugs.
A superfície de ataque do KVM é real. O Google mantém o kvmCTF justamente para encontrar esses bugs e paga bem por eles:
| Nível | Recompensa |
|---|---|
| Escape completo de VM | $250,000 |
| Gravação de memória arbitrária | $100,000 |
| Leitura de memória arbitrária | $50,000 |
| Gravação relativa de memória | $50,000 |
| Negação de serviço | $20,000 |
| Leitura relativa de memória | $10,000 |
As recompensas não se acumulam. O alvo é um kernel Linux LTS com KVM e o guest é Debian 12.5. O objetivo é um ataque do guest para o host.
Hyunwoo Kim, o mesmo pesquisador que encontrou Dirty Frag, também recebe recompensas do KVM e ganhou o prêmio completo de $250,000 por um escape de VM. Portanto, o resumo honesto é: ambas as camadas têm falhas, e às vezes a mesma pessoa encontra as duas.
Mas compare as escalas:
| Kernel Linux | Hipervisor KVM | |
|---|---|---|
| CVEs em 2026 | Quase 6.000 | Poucas, com pesquisadores individuais encontrando algumas por ano |
| Acessível a partir de | Qualquer processo sem privilégios, pela interface de syscall | Somente código que já roda dentro de um guest |
| Superfície de ataque | Tudo: rede, sistemas de arquivos, criptografia, IPC e drivers | Interface de dispositivo virtual e hypercall |
| Classe de bug | Qualquer falha de segurança de memória ou lógica em 30 milhões de linhas | Restrita à fronteira de virtualização |
A diferença é de várias ordens de grandeza, não de duas vezes. Essa lacuna é o motivo pelo qual as microVMs mudam o cálculo de risco.
O que oferece uma fronteira real
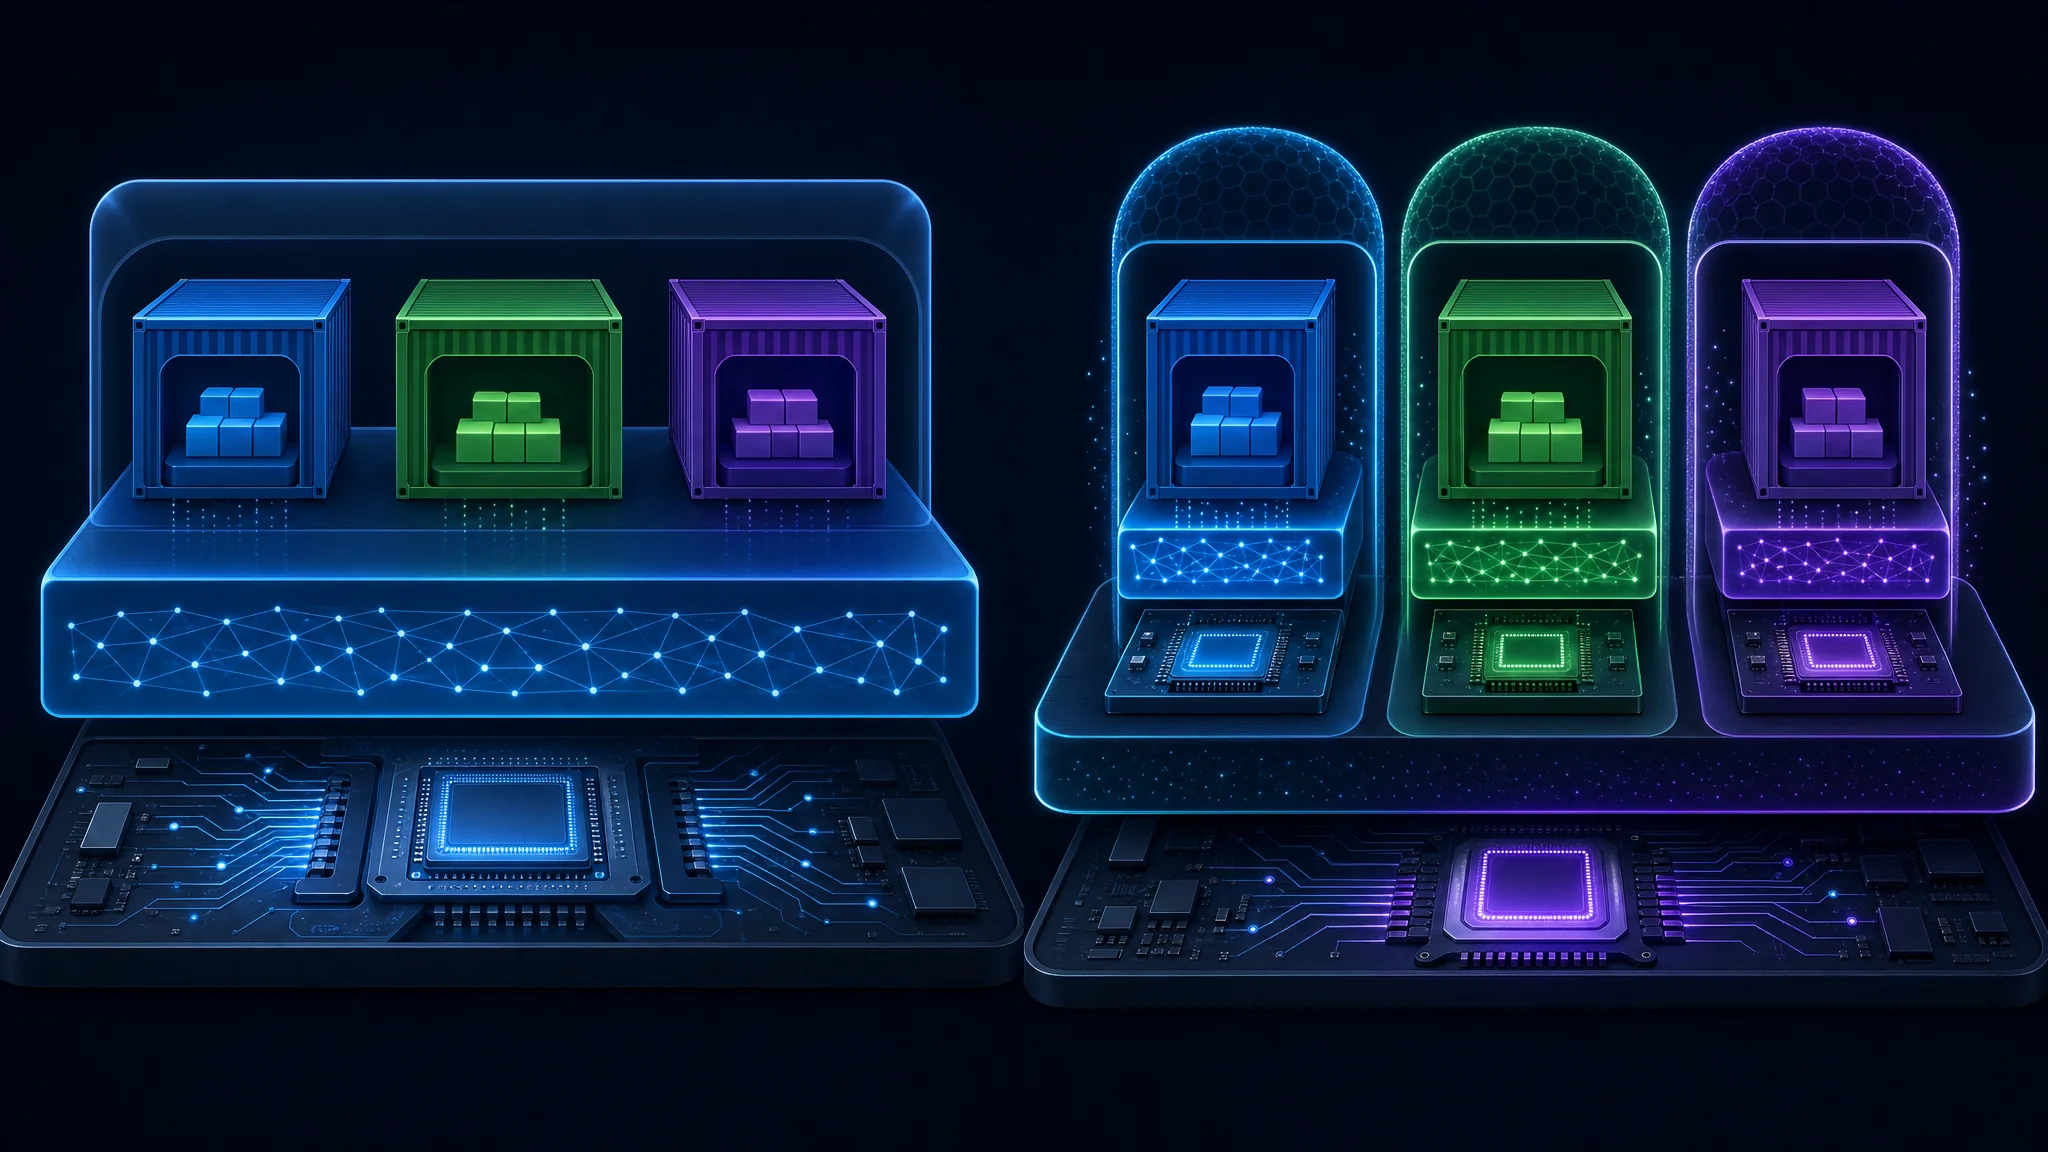
Uma microVM dá a cada carga de trabalho sua própria instância do kernel, executada sobre virtualização imposta pelo hardware, em vez de compartilhar o kernel do host por meio de namespaces.
A pilha tem três camadas que vale nomear:
- A CPU fornece mecanismos de hardware para isolar uma região de memória de outra.
- O KVM apresenta esses mecanismos ao kernel Linux, permitindo que o kernel atue como hipervisor.
- Um VMM (monitor de máquina virtual), como Firecracker ou QEMU, controla o KVM para criar e executar o guest.
Como o guest executa seu próprio kernel, um exploit de kernel dentro do guest compromete somente o guest. Não há kernel compartilhado para atacar. O atacante então precisa escapar do próprio hipervisor, a superfície menor onde ficam os bugs do KVM.
Duas implementações importam na prática, e ambas aparecem na recomendação da DepthFirst:
| Tecnologia | Abordagem | Observações |
|---|---|---|
| Firecracker | VMM criado para esse fim, modelo de dispositivos mínimo | Desenvolvido pela AWS e projetado especificamente para isolamento multi-tenant em escala |
| Kata Containers | Runtime compatível com OCI que envolve uma microVM | Executa imagens de contêiner padrão com uma fronteira de VM por baixo |
O Kata é a migração mais fácil para a maioria das equipes, porque aceita as imagens e ferramentas de contêiner que já usam. O Firecracker tem uma superfície de ataque menor, pois implementa bem menos emulação de dispositivos que um VMM de uso geral.
O que fazer agora
Nem todo contêiner precisa de uma microVM. A decisão depende de quem executa código dentro dele.
| Sua situação | Risco | O que fazer |
|---|---|---|
| Você executa seu próprio código, single-tenant | Baixo | Mantenha os contêineres. Aplique patches rapidamente, remova capabilities e mantenha o sistema de arquivos raiz somente leitura |
| Hosts multi-tenant, com shell para usuários | Alto | Mova as cargas não confiáveis para microVMs. Este é o primeiro caso destacado pela DepthFirst |
| Runners de CI que executam PRs não confiáveis | Alto | Um pull request vira root no runner. Isole cada tarefa em sua própria VM |
| Notebooks, sandboxes de agentes, serverless | Alto | O código do tenant vira root no host. Uma microVM por tenant |
| Clusters Kubernetes | Elevado | O cache de páginas é compartilhado pelo host. Um pod com as primitivas certas compromete o nó e cruza fronteiras entre tenants |
O princípio comum é simples. Contêineres são excelentes para empacotamento e isolamento de processos. Eles nunca foram projetados para conter código hostil, mas o setor silenciosamente os usou para isso porque eram convenientes e baratos.
Reforço que ajuda em qualquer caso
Nada disso substitui uma fronteira de VM, mas tudo remove caminhos fáceis:
# Disable the modules the page-cache family abuses, where they are not needed
printf 'install algif_aead /bin/false\ninstall esp4 /bin/false\ninstall esp6 /bin/false\ninstall rxrpc /bin/false\n' \
  > /etc/modprobe.d/harden-pagecache-family.conf
rmmod algif_aead esp4 esp6 rxrpc 2>/dev/null || true
# Restrict unprivileged user namespaces, which gates the ESP variants
# Debian and Ubuntu: this is a partial mitigation, not a complete one
sysctl -w kernel.unprivileged_userns_clone=0

# If exploitation is suspected, drop the page cache to discard modified in-memory binaries
echo 1 | tee /proc/sys/vm/drop_caches
# Detection starting points
- Unexpected unshare(CLONE_NEWUSER) from a workload with no legitimate reason
- NETLINK_XFRM activity, or XFRM security associations appearing outside IPsec hosts
- Requests to bind AF_ALG sockets
- Loads of esp4, esp6, or rxrpc on hosts running neither IPsec nor AFS
Aviso:
drop_cachesdescarta a cópia modificada em memória e limpa a corrupção, mas não remove um atacante que já obteve root. Trate como resposta a incidente, não como correção.
O problema da cadência de patches
Mesmo com as melhores intenções, aplicar patches no kernel virou uma corrida:
- Quase 6.000 CVEs publicadas neste ano significam que o volume, por si só, supera a maioria das janelas de manutenção.
- Um patch pode introduzir um bug. Fragnesia provou isso neste mesmo subsistema.
- A lista de mitigação vence.
algif_aeadera a resposta em abril. Em maio, já não cobria nada em Dirty Frag.
A velocidade dos patches é necessária, mas insuficiente. A arquitetura define se um patch esquecido vira um incidente contido ou o comprometimento do host.
A pergunta mais difícil: quem é o adversário?
A resposta técnica é clara. A resposta estratégica depende de uma pergunta que muitas equipes pulam.
Se seu modelo de ameaça envolve um usuário curioso ou um desenvolvedor descuidado, contêineres continuam adequados. Um escape de contêiner exige execução de código local e um exploit de kernel. Nenhum é casual, e o custo operacional de mover tudo para microVMs é real.
Se seu modelo de ameaça inclui um adversário que executa código na sua infraestrutura, contêineres agora são apenas um obstáculo pequeno. Vale citar a conclusão da DepthFirst em vez de parafraseá-la:
“A barreira de entrada para transformar essas vulnerabilidades em armas caiu tanto que precisamos presumir que os atacantes já conseguem escapar de contêineres padrão quando quiserem.”
Este é um fornecedor de segurança com um produto para vender, defendendo uma arquitetura específica. O ceticismo é justificável. Mas o argumento não depende do fornecedor. A contagem de 6.000 CVEs é pública, os exploits estão publicados e o kernel é compartilhado por projeto.
Em termos honestos: o valor da fronteira do contêiner diminui contra um atacante com acesso inicial, mas continua igual contra todo o resto.
Veredito
Contêineres continuam sendo a ferramenta certa para empacotamento, implantação e separação de processos. Deixaram de ser uma fronteira de segurança confiável contra código hostil.
Três afirmações, em ordem de confiança:
A premissa técnica está estabelecida. Contêineres compartilham o kernel do host. Cada uma das quatro vulnerabilidades deste artigo escapou da fronteira a partir de uma conta sem privilégios, e os exploits são públicos.
A IA mudou o ritmo, não o princípio. LPEs no kernel sempre existiram. Agora encontrar uma custa cerca de uma hora de varredura por IA, em vez de meses de trabalho especializado, e duas organizações encontraram o mesmo zero-day independentemente no mesmo dia.
Migrar tem custo, e não migrar também. Firecracker e Kata adicionam overhead, complexidade operacional e novas habilidades. A escolha é direta: aceitar o overhead ou aceitar que um bug no kernel comprometa o host.
Se você opera infraestrutura multi-tenant ou executa código não confiável, comece a planejar agora a migração para microVM. Não porque o céu esteja caindo, mas porque a trajetória é clara e a migração leva trimestres, não semanas.
Se você executa contêineres single-tenant com seu próprio código, mantenha-os. Aplique patches no kernel mais rápido que antes, desative módulos desnecessários e reavalie a decisão quando código não confiável entrar no ambiente.
Está acabando a era de tratar o kernel como uma fronteira de confiança incondicional. A infraestrutura que prevê uma invasão do kernel é a que sobrevive a ela.
Principais conclusões
- Contêineres compartilham o kernel do host. O isolamento vem dos namespaces da syscall
clone, não da virtualização de hardware; por isso, um bug no kernel também é um bug do contêiner. - Quatro vulnerabilidades de 2026 escaparam da fronteira a partir de contas locais sem privilégios: Copy Fail, Dirty Frag, Fragnesia e CVE-2026-80521. Todas atingem o cache de páginas.
- Quase 6.000 CVEs do kernel haviam sido publicadas até setembro de 2026, e ferramentas de IA aceleram as descobertas. Copy Fail foi encontrada em cerca de uma hora de varredura por IA.
- Fragnesia foi introduzida pelo patch de Dirty Frag. O patch produziu um novo bug que dá root no mesmo subsistema.
- A mitigação de Copy Fail não impede Dirty Frag. Bloquear
algif_aeadcobre uma vulnerabilidade e nada mais da família. - CVE-2026-80521 também comprometeu
nsjail,FirejaileBubblewrap, não somente runtimes de contêineres. - MicroVMs mudam o cálculo de risco ao dar a cada carga seu próprio kernel. O KVM tem bugs, mas a superfície é muito menor.
- Escolha com base em quem executa o código. Seu código em um contêiner single-tenant representa risco baixo. Código não confiável em um host compartilhado representa risco de comprometimento do host.
Próximas etapas
- Leia a análise que explica o problema e o exploit publicado: Contêineres não são mais uma fronteira de segurança - DepthFirst
- Consulte o aviso oficial e as orientações de mitigação da família Copy Fail: CERT/CC VU#260001
- Leia a análise técnica de Dirty Frag para entender o encadeamento e por que a mitigação com
algif_aeadfalha: Análise técnica de Dirty Frag - Consulte as regras e faixas de recompensa do kvmCTF para entender a superfície de ataque do hipervisor: Visão geral do kvmCTF
- Pontue essas CVEs no seu ambiente com nossa ferramenta no navegador: Calculadora CVSS v3.1
- Reforce o que você executa agora: Como proteger seu ambiente Docker e Kubernetes
- Entenda em detalhes a troca entre opções de isolamento: Docker versus máquinas virtuais 2026
- Reduza privilégios onde não puder adicionar uma fronteira: Controle de acesso de menor privilégio no Linux
Artigos relacionados
| Artigo | O que aborda |
|---|---|
| Docker versus máquinas virtuais 2026 | A comparação arquitetônica que fundamenta este artigo, incluindo desempenho e trocas de segurança |
| Como proteger seu ambiente Docker e Kubernetes | Práticas para reforçar a camada de contêiner, ainda importantes dentro de uma microVM |
| Docker em LXC no Proxmox: confiabilidade, evidências e migração para VM | Contêineres aninhados, evidências e quando mover uma carga para uma VM completa |
| Entendendo a virtualização: conceitos e aplicações | Fundamentos de hipervisores, incluindo os recursos de CPU necessários para microVMs |
| Controle de acesso de menor privilégio no Linux | Redução dos privilégios obtidos em um escape para limitar o impacto |
Referências
- Contêineres não são mais uma fronteira de segurança - DepthFirst (Zhenpeng Lin, 22 de setembro de 2026)
- CERT/CC Vulnerability Note VU#260001 - Copy Fail (CVE-2026-31431)
- Site oficial de divulgação de Copy Fail e análise do exploit
- Análise técnica de Dirty Frag - Hyunwoo Kim (CVE-2026-43284, CVE-2026-43500)
- Fragnesia: escalonamento local de privilégios no kernel Linux por ESP-in-TCP - Wiz (CVE-2026-46300)
- Visão geral e faixas de recompensa do kvmCTF - Google
- Entrada NVD para CVE-2026-31431
- Commit de correção upstream no mainline para Copy Fail
- Aviso de segurança do Ubuntu sobre as correções de Copy Fail
- Exploits e submissões do KernelCTF - Google Security Research
This article refers to other articles we've written:
- Docker e máquinas virtuais: comparação de 2026
Comparação de 2026 entre contentores Docker e máquinas virtuais em desempenho, segurança, custo, casos de uso e adequação à implementação.
- Como proteger seu ambiente Docker e Kubernetes
Conheça as melhores práticas para proteger seu ambiente Docker e Kubernetes, incluindo o uso de imagens oficiais, a limitação de permissões e a implementação da segurança de rede.
