Por dentro da nossa frota híbrida de agentes de IA: Hermes, LiteLLM e Tailscale

Table of Contents
Implantamos uma frota local de GPUs alocadas por solicitação e projetamos seu plano de controle híbrido. O caminho verificado começa no LiteLLM, seleciona um grupo de modelos e carrega um modelo local em uma GPU por vez. A política de níveis do Hermes é uma proposta, e um artefato de configuração do Tailscale Aperture está pronto para o próximo teste de integração. Nenhum dos dois foi verificado como parte de um fluxo completo de ponta a ponta.
As placas ociosas mineram Pearl. Uma solicitação de IA pausa a mineração somente na placa alugada, atende à solicitação, descarrega o modelo e devolve a placa ao minerador.
Principais conclusões
- T0 a T2 atendem tarefas caras ou exigentes. Esses caminhos priorizam modelos de ponta hospedados e cadeias ordenadas de contingência.
- T3 atende trabalho local substancial. A frota atribui planejamento, programação, revisão e visão a modelos de 4B a 12B.
- T4 atende trabalho local frequente. Modelos pequenos roteiam, classificam, extraem, geram embeddings e concluem tarefas de código delimitadas.
- Cada GPU é um recurso independente. Uma placa atende a IA enquanto as outras continuam minerando.
- Modelos locais ficam descarregados quando ociosos. Nenhum modelo mantém memória de GPU entre as janelas de solicitação.
- Cada gateway expõe o mesmo catálogo lógico. Aliases compartilhados distribuem trabalho entre sistemas elegíveis. Aliases prefixados pelo nó mantêm a alocação exata quando necessário.
- O broker experimental não chegou à produção. Seu teste canário atendeu a uma solicitação, mas falhou no teste de encerramento limpo. O LiteLLM permaneceu no caminho verificado por solicitação.
- Hermes e Aperture continuam em preparação. O projeto-alvo existe, mas o teste de aceitação de ponta a ponta continua pendente.
Pré-requisitos: vários hosts Linux com GPU, drivers NVIDIA estáveis, um tailnet Tailscale, systemd, um minerador funcional, armazenamento de modelos e testes de aceitação para cada caminho de modelo.
Tempo e dificuldade: avançado. Reserve vários dias para inventário, downloads de modelos, definições de serviço, testes de roteamento, exercícios de falha e verificações da retomada da mineração em cada placa.
Termos usados abaixo: um tailnet é a rede privada formada por identidades e dispositivos Tailscale. Um alias de modelo é um nome estável de modelo apresentado aos clientes. Um grupo de modelos coloca várias implantações por trás de um alias. Um proxy de pool é um pequeno serviço local que aluga uma GPU, inicia o worker do modelo e devolve a placa à mineração.
Objetivo do projeto
O trabalho agentivo assume muitas formas. Reparar um repositório exige um modelo diferente daquele usado para um título, captura de tela, embedding ou rótulo de intenção. Enviar cada turno ao maior modelo desperdiça dinheiro e capacidade local. Enviar cada turno ao menor modelo gera novas tentativas e resultados fracos.
Queríamos um catálogo único com cinco faixas de carga de trabalho. A política precisava atender modelos hospedados e locais por formatos de API conhecidos. As GPUs locais precisavam continuar produtivas entre solicitações de IA.
A frota também precisava de concorrência. Um host com várias placas deveria atender vários trabalhos independentes ao mesmo tempo. Uma solicitação em uma placa não deveria interromper a mineração em todas as placas do chassi.
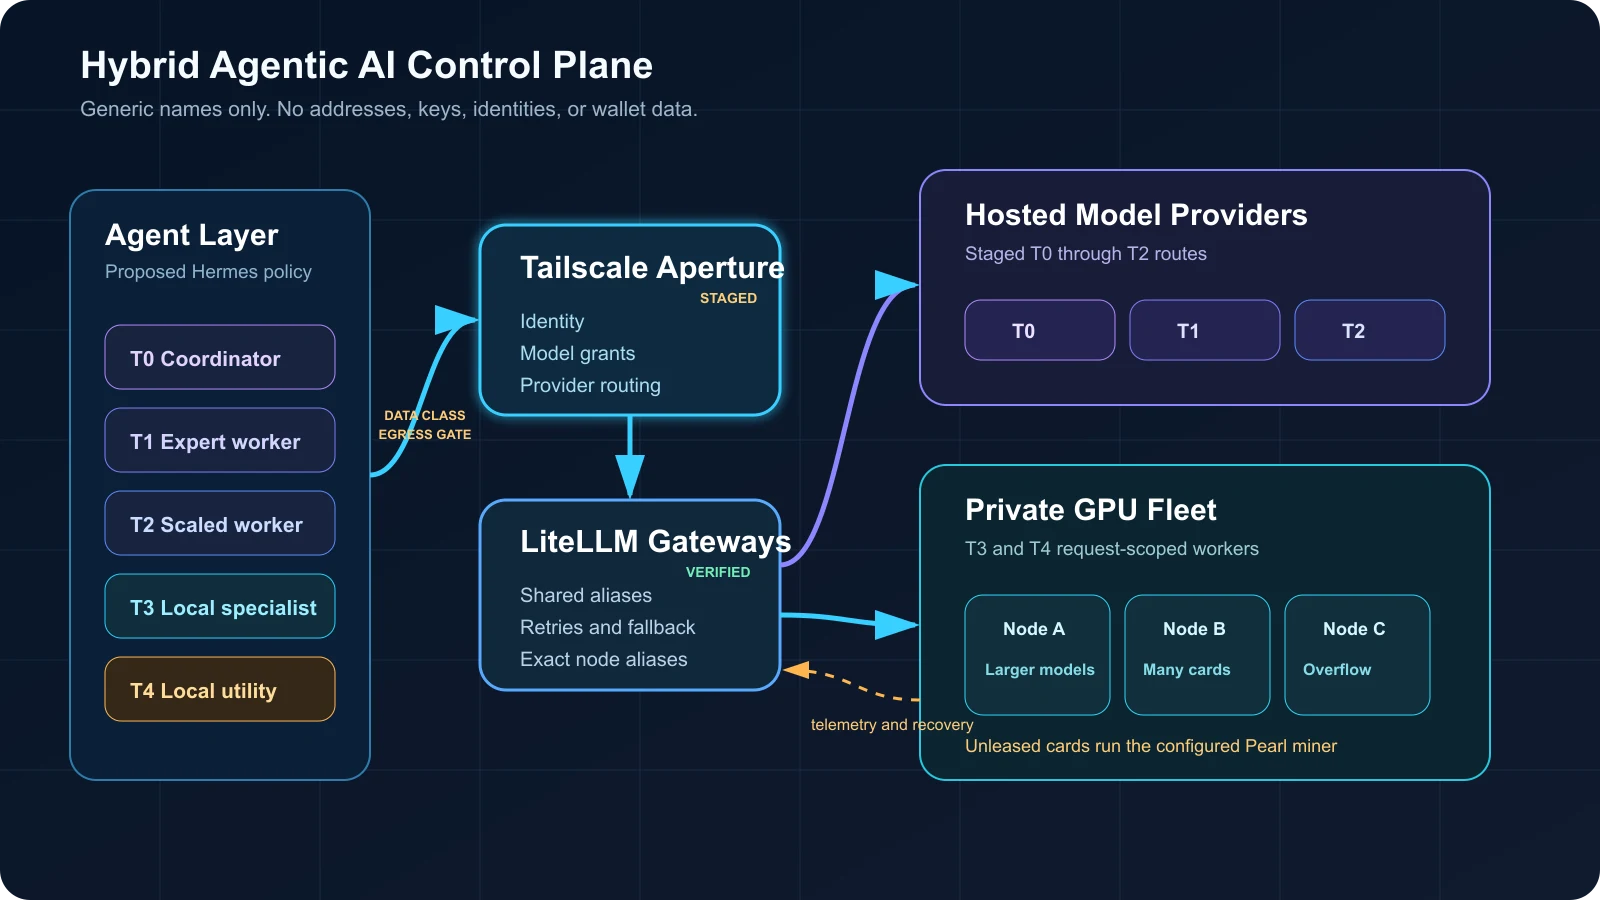
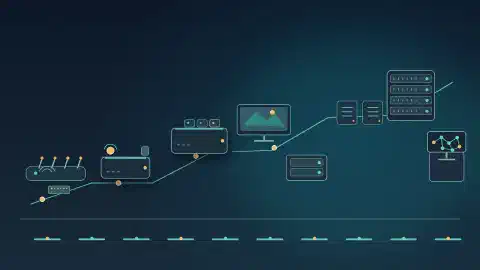
O caminho de controle proposto e em preparação fica acima do caminho de execução verificado do LiteLLM por GPU
O diagrama usa nomes genéricos de nós. Ele omite endereços privados, identidades de usuários, chaves de acesso, dados de carteiras e rótulos dos hosts físicos.
O que T0 a T4 significam
Os nomes dos níveis representam nossa política de roteamento. Não são um padrão do setor e não descrevem apenas o tamanho do modelo.
| Nível | Função principal | Destino típico | Comportamento em caso de falha |
|---|---|---|---|
| T0 | Coordenador padrão e decisões mais difíceis | Modelo de raciocínio de ponta hospedado | Cadeia ordenada de contingência hospedada |
| T1 | Agentes workers de alto valor | Pool hospedado de modelos de alta capacidade | Tentar novamente na cadeia atribuída |
| T2 | Pool geral de workers | Modelos hospedados rápidos, com escalonamento | Escalonar trabalho difícil para T1 ou T0 |
| T3 | Trabalho local privado substancial | Modelos locais de chat, código, revisão e visão de 4B a 12B | Tentar em outro nó local elegível e depois falhar de forma fechada para dados restritos |
| T4 | Trabalho local restrito e frequente | Modelos locais de roteamento, classificação, código e embeddings de 0,6B a 3B | Tentar novamente em uma réplica local ou passar para T3 dentro do mesmo limite de dados |
Os níveis descrevem a tarefa antes de descrever o modelo. Uma classificação curta e sensível à segurança cabe em T4. Um plano longo para um repositório cabe em T3 ou acima. Uma decisão arquitetural difícil começa em um nível superior mesmo quando o prompt é curto.
Essa divisão também muda a economia dos agentes. Workers T4 absorvem transformações repetidas de baixo risco. Workers T3 mantêm código comum e análise dentro do tailnet. T0 a T2 continuam disponíveis para trabalho difícil e recuperação de falhas.
Um filtro de classe de dados deve preceder todo fallback hospedado. Trabalhos públicos, internos e restritos recebem cadeias separadas. Trabalhos restritos permanecem locais e falham de forma fechada. Uma nova tentativa que cruze o limite exige entrada sanitizada e aprovação explícita do usuário ou do fluxo de trabalho. A redação remove credenciais, segredos do repositório, saída privada de ferramentas e conteúdo sensível recuperado antes de qualquer chamada hospedada.
Como Hermes controlará a política das tarefas
Hermes é a camada de agentes proposta. A política-alvo atribui uma classe de modelo, executa ferramentas, delega trabalho e percorre cadeias explícitas de contingência. Hermes documenta rotas separadas para o modelo principal, trabalhos auxiliares, agentes delegados e fallbacks específicos da tarefa. Também aceita endpoints personalizados compatíveis com OpenAI por meio de uma URL base. Consulte o guia de configuração do Hermes e o guia de provedores de fallback .
Nossa política associa tarefas Hermes a aliases estáveis em vez de servidores físicos. Exemplos:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
O alias expressa a intenção. Hermes não precisa saber qual GPU está livre, qual nó tem uma placa maior nem qual réplica falhou na verificação de integridade. As camadas inferiores cuidam dessas decisões.
Alguns trabalhos ainda exigem alocação determinística. Um ID de modelo prefixado pelo nó envia um diagnóstico do operador ou benchmark a um sistema selecionado. Grants Aperture separados devem restringir esses aliases aos operadores. O tráfego normal dos agentes usa aliases de nível compartilhados.
O acesso aos modelos não protege as ferramentas dos agentes. A implantação do Hermes precisa de listas de permissão de ferramentas com privilégio mínimo, espaços de trabalho isolados, credenciais de escopo limitado, controles de tráfego de saída da rede e tratamento de injeção de prompt. Workers delegados não devem herdar mais acesso do que a tarefa atribuída exige.
Aperture é o limite de identidade em preparação
Tailscale conecta o gateway configurado e os hosts de inferência sem publicar cada serviço na internet pública. Aperture está sendo preparado como limite voltado ao usuário e roteador de modelos. Esse caminho ainda precisa de um teste de aceitação de ponta a ponta. A Tailscale documenta o acesso criptografado de clientes pelo tailnet e o encaminhamento de provedores por TLS em Como o Aperture funciona .
Aperture também separa alcance de permissão. Seus grants negam acesso por padrão. Depois de chegar ao gateway, um usuário ou dispositivo marcado precisa de um grant de modelo correspondente. O guia de grants do Aperture explica o modelo aditivo de grants e as fontes de identidade.
Antes da implantação, a configuração do Aperture em preparação deve seguir quatro regras:
- Uma identidade nomeada detém o papel de administrador. O acesso geral aos modelos não concede administração.
- Os provedores listam IDs literais de modelos. Aperture não deduz modelos de um serviço upstream.
- URLs dos provedores apontam para endereços do tailnet. Nomes e endereços privados dos nós ficam fora do artigo e dos exemplos públicos de configuração.
- Segredos ficam em arquivos pertencentes ao serviço. Antes da implantação, aplique permissões somente para o proprietário, contas de serviço restritas, rotação e redação dos logs. A saída de diagnóstico nunca deve imprimir chaves LiteLLM, endereços tailnet, tokens de assinatura ou dados de carteira.
Aperture acrescenta o caminho da solicitação recebida à URL base de cada provedor. Sua
referência de configuração
adverte contra incluir um sufixo /v1 duplicado na raiz do provedor. Esse detalhe trouxe risco de integração suficiente para merecer uma verificação explícita.
A visão está preparada para passar pelo formato OpenAI Chat Completions com conteúdo de imagem. Embeddings usam diretamente o endpoint LiteLLM privado porque a matriz atual de provedores auto-hospedados do Aperture documenta formatos de chat, enquanto nosso caminho de embeddings depende de endpoints LiteLLM e llama.cpp fora do seletor de chat. Consulte a referência de provedores e clientes compatíveis .
O caminho direto de embeddings precisa do próprio limite de autorização. Autenticação LiteLLM, grants Tailscale restritivos, vínculo do serviço à interface do tailnet e regras de firewall do host devem limitar o acesso a identidades ou tags de serviço aprovadas. Um endereço privado, sozinho, não é uma política de autorização.
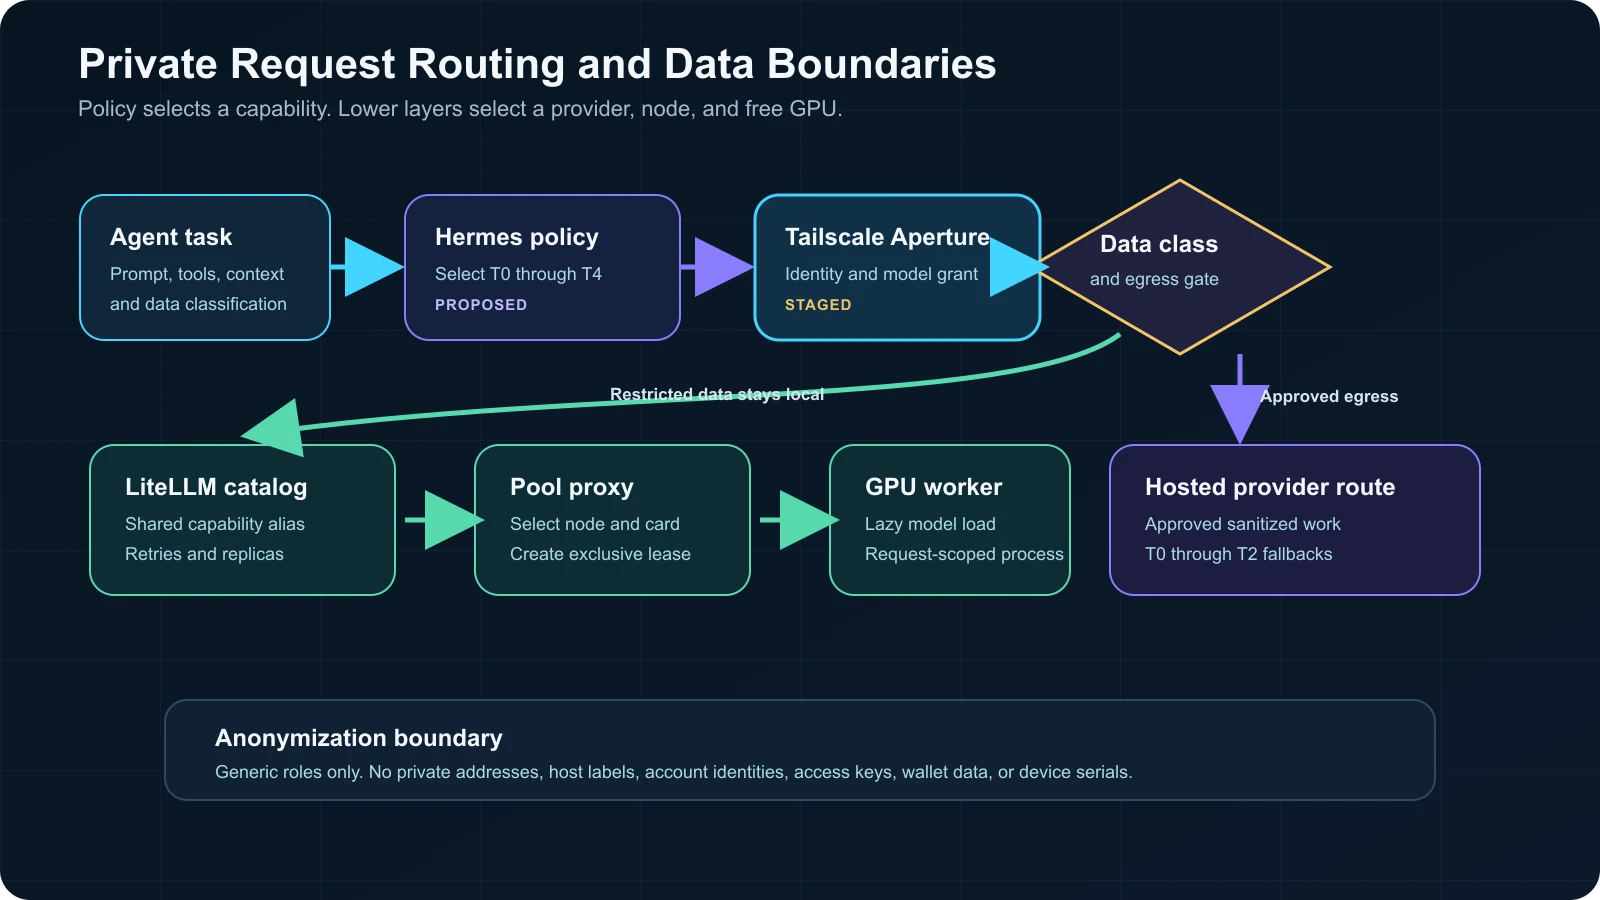
Identidade, grants e classificação de dados decidem se uma solicitação deixa a frota privada
LiteLLM apresenta um catálogo único
Cada host de inferência executa um gateway LiteLLM. Todos os gateways expõem o mesmo catálogo lógico de modelos, mesmo quando um modelo está em outro nó. O cliente mantém um único formato de API e um conjunto de aliases.
LiteLLM agrupa várias implantações sob um nome de modelo. O roteador seleciona então uma implantação elegível e aplica novas tentativas, limites de tempo, períodos de espera ou fallbacks. A documentação atual de roteamento do LiteLLM aborda nomes compartilhados de modelos, estratégias de roteamento e comportamento de novas tentativas.
O catálogo tem dois estilos de endereço:
| Estilo de endereço | Exemplo | Uso |
|---|---|---|
| Alias compartilhado | t4-classify | Distribuir trabalho normal entre nós elegíveis |
| Alias de nó | node-b/qwen-small | Executar diagnósticos ou preservar a alocação |
Aliases compartilhados oferecem escala horizontal sem alterar Hermes. Adicionar uma réplica elegível amplia o grupo de modelos. Remover uma réplica com problemas reduz o grupo.
Mantemos a lógica do ciclo de vida da GPU abaixo do LiteLLM. O gateway permanece ativo porque sua memória não reserva memória de GPU. Um proxy de pool local recebe a solicitação do modelo selecionado, aluga uma placa, inicia o worker e o encerra após a resposta.
Catálogo local de modelos
A frota prioriza modelos com até 12B parâmetros. Esse limite corresponde à memória das placas disponíveis e deixa espaço para contexto e buffers de execução.
Notação dos modelos: B significa bilhões de parâmetros. K significa milhares de tokens de contexto configurados. Quantização armazena pesos com precisão numérica reduzida para diminuir o uso de memória. O cache KV mantém o estado de atenção do contexto ativo e cresce com o comprimento do prompt. E4B é o rótulo de tamanho da Google para a variante menor do Gemma 4.
| Rota de nível | Classe do modelo | Contexto configurado | Trabalho principal | Alocação |
|---|---|---|---|---|
| T3 inteligente | Qwen3.5 9B, quantizado | 64K | Planejamento local difícil e trabalho geral de agente | Nós GPU com mais memória |
| T3 código | Granite 4.2 8B, quantizado | 64K | Trabalho em repositórios, ferramentas, terminal e saída estruturada | Nós GPU com mais memória |
| T3 revisão | Gemma 4 12B, quantizado | 32K | Revisão independente e raciocínio alternativo | Nós GPU com mais memória |
| T3 geral e visão | Qwen3.5 4B, quantizado | 32K | Trabalho geral escalado e compreensão de imagens | Todas as GPUs compatíveis |
| T3 revisão alternativa | Gemma 4 E4B, quantizado | 8K | Caminho de revisão diverso | Todas as GPUs compatíveis |
| T4 código | Granite 4.2 3B, quantizado | 16K | Pequenas edições, chamadas de ferramenta e saída estruturada | Todas as GPUs compatíveis |
| T4 classificação | Qwen3.5 2B, quantizado | 16K | Classificação, extração e reescrita | Todas as GPUs compatíveis |
| T4 roteador | Qwen3.5 0.8B, quantização de alta precisão | 16K | Intenção, rótulos, títulos e transformações curtas | Todas as GPUs compatíveis |
| T4 embeddings | Qwen3 Embedding 0.6B, quantizado | 32K | Memória de agente, RAG, recuperação de código e agrupamento | Todas as GPUs compatíveis |
Esses valores de contexto são configurações de implantação, não limites anunciados do modelo. Uma janela anunciada maior também consome cache KV e memória de execução. Escolhemos valores menores para serviço estável em uma única placa.
Qwen descreve Qwen3.5 como uma família multimodal e publica variantes densas, das menores às maiores, na coleção Qwen3.5 . IBM publica resultados de codificação agentiva e contexto longo para Granite 4.2 8B . Google informa que Gemma 4 aceita entrada multimodal, chamada de funções e uma janela anunciada maior.
A rota de embeddings usa um modelo separado em vez de pedir vetores a um modelo de chat. O cartão do modelo Qwen3 Embedding 0.6B lista sequência de 32K, recuperação multilíngue e de código, e dimensões de saída de até 1.024.
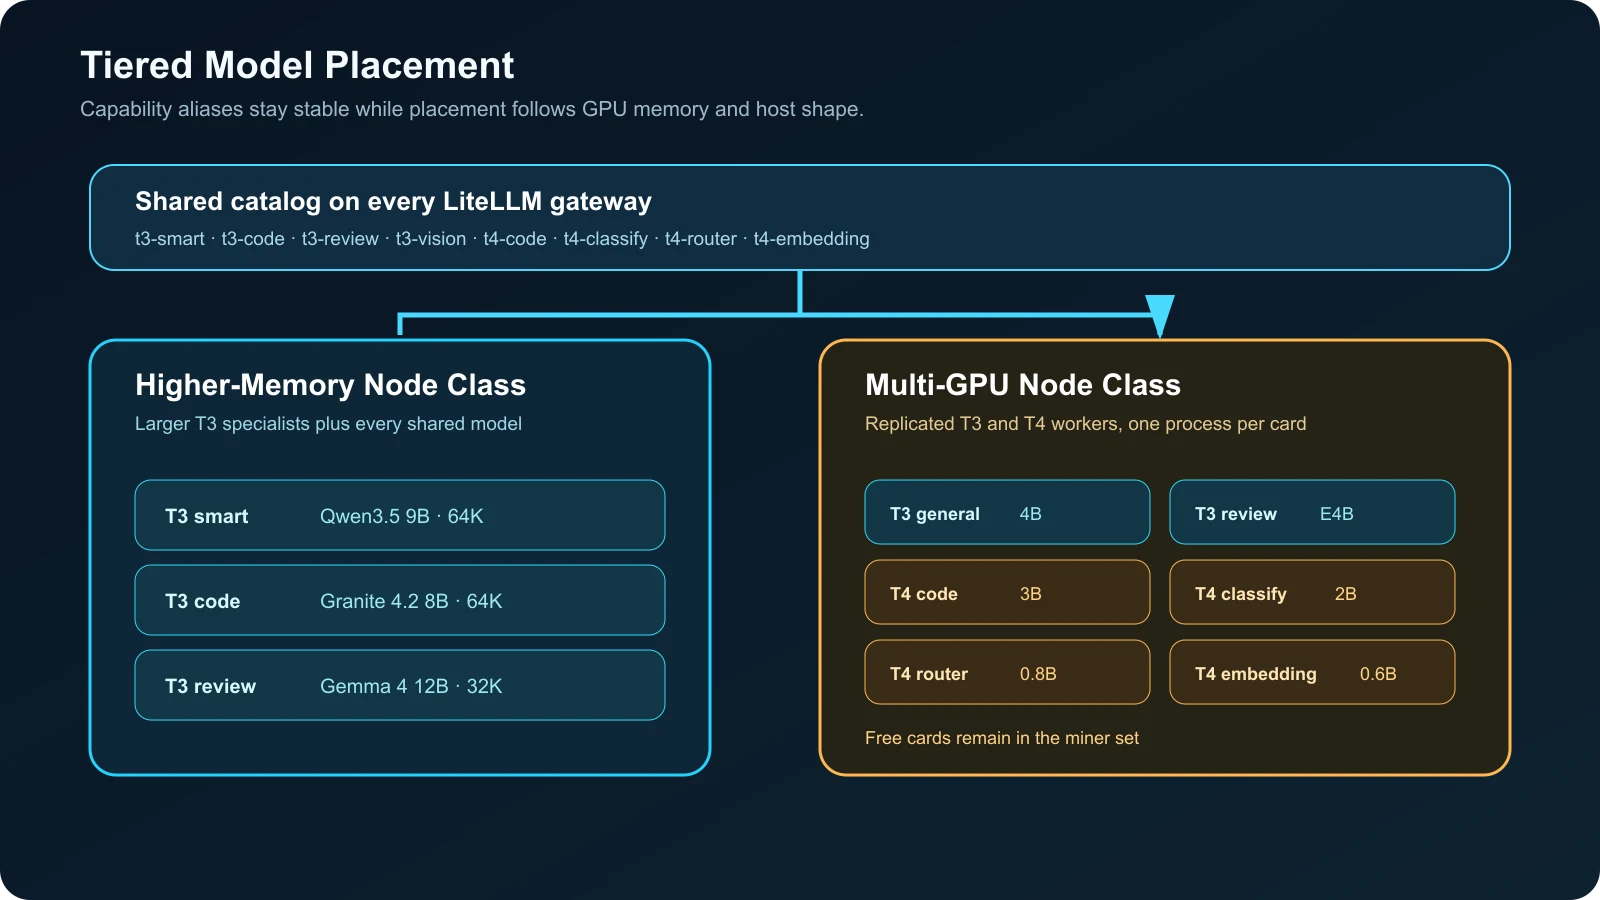
Especialistas maiores ficam em placas com mais memória, enquanto especialistas menores se replicam pela frota
Por que llama.cpp executa a produção
llama.cpp corresponde ao modelo de recursos. Um worker estático corresponde a uma GPU, um arquivo de modelo, um contexto configurado e um lease. O limite do processo facilita auditar inicialização, encerramento, visibilidade da GPU e logs.
Seu servidor expõe chat, respostas e embeddings compatíveis com OpenAI. Também oferece decodificação paralela e processamento contínuo em lotes. A documentação atual do servidor marca o suporte multimodal como experimental. Esses recursos constam na documentação do servidor llama.cpp .
Ollama continua disponível como caminho de compatibilidade em um nó maior. Ollama permite carregar modelos em paralelo quando a memória é suficiente e descarregá-los imediatamente com keep_alive: 0, conforme a
FAQ do Ollama
. Não escolhemos Ollama para o caminho de produção por placa porque workers estáticos llama.cpp oferecem controle mais preciso da alocação e do encerramento.
Também avaliamos Strata. Strata tem como alvo um grande modelo Qwen mixture-of-experts distribuído entre memória de GPU, RAM do sistema e armazenamento. Seus presets publicados começam com 32 GB de memória combinada, enquanto o modo de pouca RAM troca velocidade por menor capacidade. Consulte o repositório Strata . Strata atende a outro objetivo: um modelo híbrido maior em uma ou mais placas. Nossa frota prioriza muitos workers independentes abaixo de 12B.
Carregamento sob demanda por GPU
O carregamento sob demanda se aplica a cada worker de modelo. Entre solicitações, o sistema mantém ativos somente gateways, proxies de pool, watchdogs e o minerador.
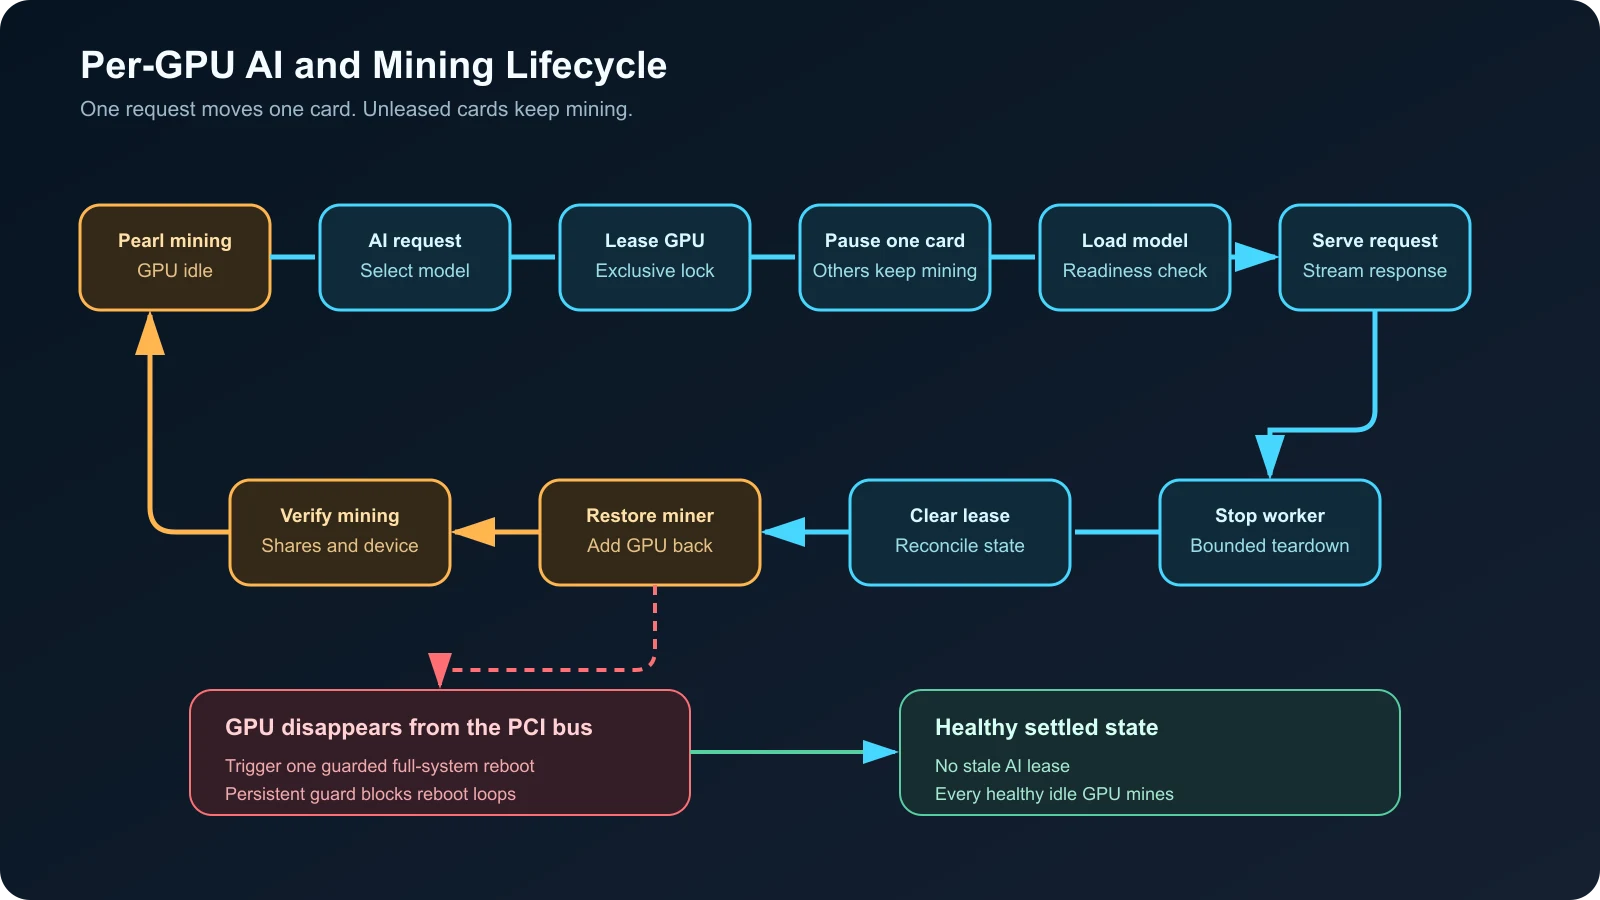
Somente a placa alugada deixa o minerador e retorna depois que o processo do modelo termina
O ciclo de vida da solicitação segue estas etapas:
- LiteLLM seleciona uma implantação. A solicitação chega ao proxy de pool da classe de modelo escolhida.
- O pool obtém um lease. Um bloqueio impede que dois workers exclusivos usem a mesma placa.
- O minerador reinicia sem uma GPU. Cada placa não alugada continua no comando Pearl.
- llama.cpp inicia no dispositivo alugado. As verificações de prontidão terminam antes que o proxy encaminhe a solicitação.
- O worker atende à resposta. Solicitações simultâneas iniciam workers em outras placas livres.
- O worker termina. O pool remove o lease após o encerramento do processo.
- O minerador reinicia com a GPU liberada. Verificações de integridade confirmam que a placa voltou à mineração.
Isso difere de alternar o host inteiro. Um chassi com várias placas atende vários modelos enquanto as placas restantes continuam minerando. Quando ociosa, a frota devolve todas as GPUs saudáveis à Pearl.
O whitepaper da Pearl descreve seu sistema de prova por cálculo matricial. Nossa arquitetura não depende de previsão de lucratividade nem afirma retorno econômico. Mineração é a carga de trabalho configurada para períodos ociosos.
O tratamento de falhas importa mais que a inicialização
A inicialização do modelo cobre apenas metade do ciclo de vida. Paradas forçadas, GPUs desaparecidas, solicitações interrompidas, leases antigos e reinicializações do minerador exigem tratamento explícito.
Nosso watchdog compara o conjunto de GPUs configurado à lista ativa de dispositivos NVIDIA. A confirmação de uma GPU ausente aciona uma única reinicialização completa do sistema com proteções. Um gatilho seguro para produção deve exigir verificações repetidamente malsucedidas, um período de espera, drenagem de tarefas ativas, contador persistente de reinicializações e alerta remoto. Uma recuperação malsucedida deve parar a automação e exigir intervenção manual.
O mesmo watchdog reconcilia leases antigos. Se nenhum worker possui o lease, a reconciliação remove o registro antigo e devolve a GPU ao minerador. Esse caminho de recuperação foi importante durante o teste canário do broker.
| Falha | Resposta |
|---|---|
| Modelo falha na verificação de prontidão | Parar o worker, liberar o lease, restaurar a mineração e retornar erro |
| Solicitação termina inesperadamente | Limitar o tempo da limpeza, encerrar a árvore de processos do worker e reconciliar o lease |
| GPU desaparece | Confirmar ausências repetidas, drenar trabalho ativo, executar uma reinicialização protegida, alertar e depois verificar o conjunto completo de GPUs configuradas |
| Minerador omite uma placa ociosa | Reconstruir a lista de dispositivos a partir dos leases ativos e reiniciar o minerador |
| Implantação LiteLLM falha | Tentar outra réplica do mesmo grupo de modelos e então seguir a política de fallback |
| Grant Aperture bloqueia uma rota | Corrigir a identidade ou o grant do modelo, sem contornar a política do gateway |
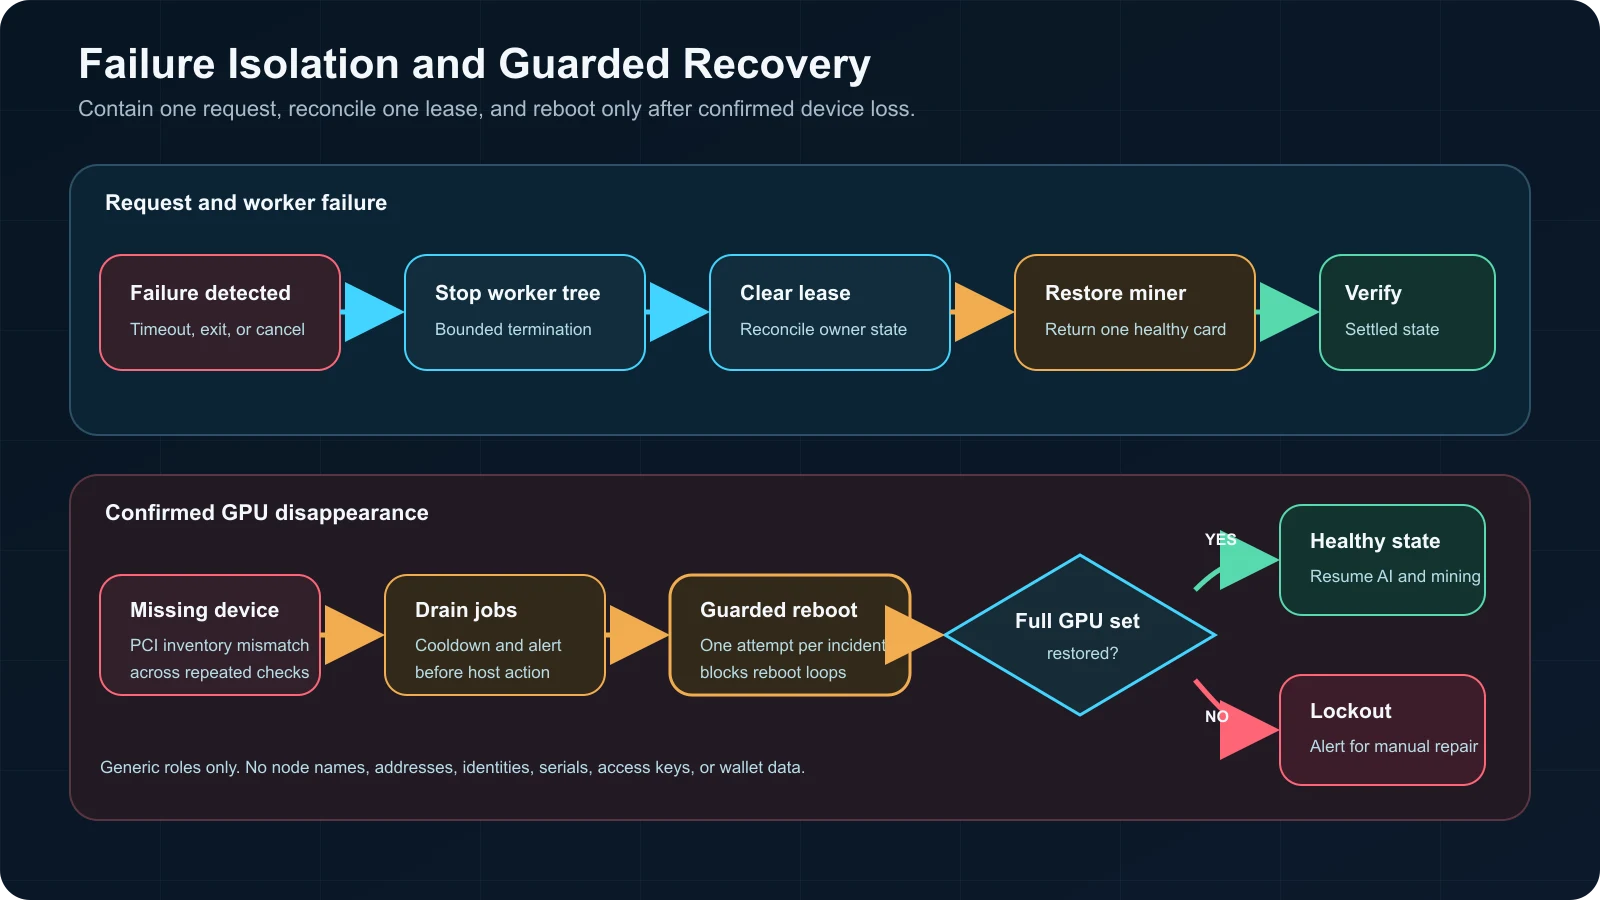
Falhas comuns liberam um lease, enquanto a perda confirmada do dispositivo entra no caminho protegido de recuperação do host
O que ocorreu com o broker experimental
O broker independente do backend pretende oferecer uma única interface compatível com OpenAI para Ollama, vLLM, llama.cpp e Strata. Inclui gerenciamento do ciclo de vida por modelo, descarregamento em repouso e alocação de GPU.
Testamos a versão 0.6.0 do broker no commit c12b65 em 21 de outubro de 2026. Sua suíte local informou 1.101 testes aprovados e 2 ignorados, com Ruff sem problemas. O canário então carregou um modelo sob demanda e atendeu a uma solicitação de chat bem-sucedida. As outras GPUs continuaram minerando durante a solicitação.
O encerramento revelou um problema crítico do ciclo de vida. Depois que um modelo era carregado, o broker ficava preso no processo de parada até o systemd encerrar a árvore de processos. A parada forçada deixou um lease de GPU antigo até que a reconciliação restaurasse o minerador. Também encontramos uma diferença entre a configuração documentada de GPU obrigatória e a aplicação pelo adaptador de produção.
Desativamos o broker no caminho de produção. LiteLLM agora roteia pelo proxy de pool por solicitação. O broker continuará experimental até que encerramento limitado de processos filhos, término de grupos de processos, verificações de admissão da GPU obrigatória e limpeza de leases antigos passem nos testes de integração.
Esse resultado traz uma lição útil de engenharia. Um broker pouco prova quando inicia um modelo uma vez. A prontidão para produção depende de encerramento limpo, recuperação limitada, admissão exclusiva de dispositivos e exercícios de falha repetíveis.
Verificações realizadas
O teste de implantação cobriu mais do que uma resposta de modelo:
- Cada modelo de chat compartilhado completou o ciclo de carregamento, resposta, saída e recuperação Pearl em pelo menos um host elegível.
- A visão aceitou entrada de imagem pelo caminho de chat.
- Embeddings retornaram o tamanho de vetor configurado pelo caminho privado LiteLLM.
- Vários modelos rodaram ao mesmo tempo em placas separadas.
- Placas não alugadas permaneceram no minerador durante solicitações simultâneas de IA.
- Aliases compartilhados rotearam solicitações entre nós elegíveis.
- Aliases prefixados pelo nó preservaram alocação determinística.
- Cada gateway LiteLLM listou o mesmo catálogo lógico.
- Uma GPU ausente foi recuperada após uma reinicialização completa do host. O watchdog agora tem uma proteção persistente contra loops.
- Uma falha de encerramento do broker foi recuperada por reconciliação do lease.
- O estado final estabilizado não tinha leases de IA e cada GPU saudável havia retornado ao conjunto do minerador.
Verificações de integridade e listas de modelos não foram tratadas como testes de carregamento de modelos. Um teste de aceitação útil envia uma solicitação real, verifica a resposta, confirma a GPU selecionada, acompanha o encerramento e verifica a retomada da mineração.
Solução de problemas da frota
| Sintoma | Primeira verificação |
|---|---|
| Modelo aparece, mas solicitações falham | ID do modelo upstream, formato da API, cabeçalho de autenticação e URL base do provedor |
| Aperture retorna 405 | A raiz do provedor não tem um sufixo /v1 duplicado |
| Nó errado atende à solicitação | Alias compartilhado ou alias prefixado pelo nó |
| Dois workers usam a mesma placa | Bloqueio de lease, estado de lease antigo e lógica de admissão da GPU |
| A mineração para em todas as placas | O código de reinicialização do minerador cria a lista de dispositivos a partir dos leases ativos |
| GPU continua fora da mineração | Árvore de processos do worker, reconciliação do lease e lista de dispositivos do minerador |
| Carregamento a frio é lento | Tamanho do modelo, velocidade do armazenamento, largura da conexão PCIe e pressão da CPU do host |
| Prompts longos falham | Contexto configurado, margem do cache KV e reserva de saída |
| Rota de embeddings não existe no Aperture | Use a rota LiteLLM autenticada, restrita pela identidade Tailscale e política de firewall do host |
| Parada do broker trava | Desative a rota do broker e retorne o tráfego ao proxy de pool verificado |
Regras de projeto que vale manter
- Roteie pelo propósito do trabalho. O tamanho do modelo, sozinho, não define o nível.
- Mantenha a política acima da alocação. Hermes escolhe um alias de capacidade. LiteLLM escolhe uma implantação. O pool escolhe uma GPU.
- Trate cada GPU como um lease separado. Alternar o host inteiro desperdiça placas disponíveis.
- Descarregue todo modelo ocioso. Gateways ativos não precisam de workers GPU ativos.
- Mantenha um caminho restrito de alocação exata. Aliases de nó somente para operadores tornam os diagnósticos reproduzíveis.
- Teste o encerramento primeiro. Recuperação do minerador e limpeza do lease fazem parte dos testes de aceitação.
- Separe chat, visão e embeddings. Um gateway não implica um único caminho de protocolo.
- Mantenha detalhes privados fora dos diagramas. Publique funções e fluxos, não endereços, chaves, identidades ou dados de carteira.
- Proteja a lógica de reinicialização. Exija ausências repetidas, período de espera, contador persistente, alerta e intervenção manual após uma recuperação malsucedida.
- Mantenha um caminho experimental alternativo. A falha de um broker não deve derrubar junto o caminho verificado.
Próximos passos
A próxima fase é a avaliação de cargas de trabalho. Cada nível precisa de um conjunto fixo de tarefas, critérios de aceitação, registros de latência, ocupação da GPU, tempo de interrupção da mineração e taxas de escalonamento. Essas medições mostrarão quais tarefas T2 cabem em T3 e quais tarefas T3 cabem em T4.
Também planejamos executar o primeiro teste de aceitação de Hermes por Aperture por LiteLLM e depois testar o broker novamente após corrigir seus caminhos de encerramento e admissão de GPU. A geração de imagens precisa do próprio adaptador compatível com OpenAI e carregamento sob demanda antes de entrar no mesmo catálogo de roteamento.
Para dimensionar modelos, leia o guia de contexto de modelos locais de IA e GPU . Para limites de privacidade, leia Privacidade e segurança da IA local . Para configuração e riscos de mineração, leia o guia de mineração Pearl em vez de tratar a mineração ociosa como lucro garantido.
Related Posts