16 GB de VRAM são suficientes para trabalho sério com LLM local?
Table of Contents
16 GB de memória dedicada da GPU atendem a trabalhos sérios com LLM local quando o modelo, o contexto e o runtime cabem juntos. Carregar os pesos comprova apenas o primeiro requisito. Uma configuração útil também precisa de memória para a conversa em andamento e velocidade suficiente para concluir a tarefa.
Use o Qwen3.8 27B como exemplo para dimensionar um fluxo de programação ou documentos para um usuário. Comece pelo contexto exigido pela tarefa e depois escolha pesos e configurações de runtime que caibam na memória restante. As especificações de hardware e as fontes do modelo foram verificadas em 7 de outubro de 2026.
Principais conclusões
- Reserve memória para o contexto antes de escolher uma quantização.
- Meça o processamento do prompt separadamente da velocidade de saída.
- Desative o suporte de visão não utilizado e teste um cache KV de 8 bits.
- Compare a GPU, o backend, o arquivo do modelo e o tamanho do prompt exatos.
- Calcule a economia de propriedade com base no seu uso e na sua conta do provedor.
Para o exercício de dimensionamento, você precisa do log de memória do runtime, do nome exato do arquivo do modelo e de uma tarefa representativa. Reserve cerca de 20 minutos para configurar e registrar os resultados, além do tempo de inferência. A dificuldade é intermediária.
Combine a memória com o trabalho
16 GB servem para uma carga de trabalho na qual os pesos, o contexto ativo e as alocações temporárias permaneçam dentro da memória disponível da GPU. O contexto necessário depende da tarefa. Um resumo curto de documento e um agente de programação que lê dezenas de arquivos precisam de orçamentos diferentes.
| Carga de trabalho | Primeira pergunta de dimensionamento |
|---|---|
| Chat curto ou redação | O modelo atinge sua meta de qualidade? |
| Análise de documentos | O texto de origem e a resposta cabem juntos? |
| Agente de programação | Quanto contexto os arquivos e os resultados das ferramentas consomem? |
| Solicitações simultâneas | Quanto cache cada sessão ativa precisa? |
Uma janela configurada difere de uma janela ocupada. Um benchmark com limite de 64K e prompt curto não mede a geração depois de 55K tokens de conversa. Teste perto do tamanho esperado da sessão antes de escolher o hardware.
Por que o modelo cabe
A quantização armazena os pesos com menos bits. A tabela de arquivos Qwen3.8 27B da Bartowski lista Q4_K_M com 17,44 GB, já acima dos aproximadamente 17,18 bilhões de bytes de um dispositivo de 16 GiB antes da memória do runtime.
O cartão do modelo GSQ-RCO da ISTA-DASLab lista IQ3_S com 11,8 GB. O método atribui precisão diferente a tensores diferentes dentro de um orçamento de tamanho. A versão MTP opcional adiciona cerca de 0,35 GB, enquanto o projetor de visão adiciona cerca de 0,9 GB.
| Benchmark publicado | Pontuação BF16 / IQ3_S |
|---|---|
| AIME25 | 100.00 / 100.00 |
| LiveCodeBench v6 | 85.71 / 85.71 |
| GPQA-Diamond | 89.90 / 89.39 |
O laboratório chama esse ponto de operação de “task-lossless”. Esses resultados selecionados sustentam uma comparação estreita. Eles não provam respostas idênticas, recuperação igual em contexto longo ou confiabilidade igual nas suas tarefas de programação. Teste o modelo comprimido contra seus próprios critérios de aceitação.
Conte o cache
O cache KV armazena as chaves e os valores de atenção dos tokens já processados. Seu prompt, a saída das ferramentas e as respostas geradas consomem contexto. Alguns runtimes alocam a capacidade do cache na inicialização, portanto a memória exibida não precisa crescer a cada mensagem.
A configuração do Qwen especifica 64 camadas, atenção completa a cada quarta camada, quatro cabeças KV e dimensão de cabeça 256. Para essas 16 camadas de atenção completa, o custo calculado do cache FP16 é:
16 layers × 4 KV heads × 256 elements × 2 (K and V) × 2 bytes
= 65,536 bytes per token
= 64 KiB per token
Esse cálculo exclui estado recorrente, alinhamento, buffers temporários e alocações de decodificação especulativa. Outras arquiteturas exigem cálculos diferentes.
| Tokens ocupados | Cache de atenção completa FP16 |
|---|---|
| 32,768 | 2 GiB |
| 65,536 | 4 GiB |
| 131,072 | 8 GiB |
| 262,144 | 16 GiB |
Aqui, KiB e GiB usam potências de 1024. Os tamanhos de download do modelo usam GB decimais. Misturar as unidades distorce o orçamento restante.
Dimensione o contexto disponível
Duas configurações liberam memória para sessões de texto mais longas: remova um projetor de visão não utilizado e reduza a precisão do cache. Calcule o efeito delas contra o modelo carregado e as alocações do runtime.
Use este exemplo, com todas as alocações expressas em GB decimais. A reserva de 1,0 GB abaixo é uma hipótese de planejamento, não um padrão universal do runtime.
| Alocação | Visão ligada / visão desligada |
|---|---|
| Capacidade física de 16 GiB | 17.180 / 17.180 GB |
| Pesos do modelo | 11.800 / 11.800 GB |
| Cabeça MTP opcional | 0.350 / 0.350 GB |
| Estimativa do projetor de visão | 0.930 / 0 GB |
| Outras alocações assumidas | 1.000 / 1.000 GB |
| Disponível para cache crescente | 3.100 / 4.030 GB |
Com 65.536 bytes por token, 3,100 GB comportam cerca de 47.300 tokens. Com armazenamento ideal de 8 bits, seriam 32.768 bytes por token e cerca de 123.000 tokens com a visão desativada.
O armazenamento q8_0 real inclui escalas de bloco. Com 34 bytes por 32 valores, este exemplo precisa de cerca de 34.816 bytes por token, reduzindo a estimativa para aproximadamente 115.700. Alocações adicionais reduzem ainda mais o resultado. Cerca de 110K é, portanto, um resultado plausível de planejamento sob essas hipóteses, não uma configuração garantida.
O contexto restante precisa cobrir entrada e saída. Com uma janela de 65.536 tokens, um prompt inicial ilustrativo de 30.000 tokens e uma permissão de saída de 8.192 tokens deixam 27.344 tokens para arquivos, resultados de ferramentas e conversa. O orçamento do prompt inicial é um exemplo. Meça suas próprias ferramentas e instruções.
Configurações que vale testar
A documentação do servidor llama.cpp documenta tipos separados para os caches de chave e valor, carregamento automático do projetor e slots paralelos. Para uma carga somente de texto, teste visão desativada, q8_0 nos dois tipos de cache e um slot. Comece com um contexto moderado.
Registre as alocações resultantes antes de aumentar o contexto. A quantização do cache precisa de suporte da arquitetura e do backend escolhidos. Teste a qualidade das respostas depois de mudar a precisão. Mantenha uma configuração funcional para comparação.
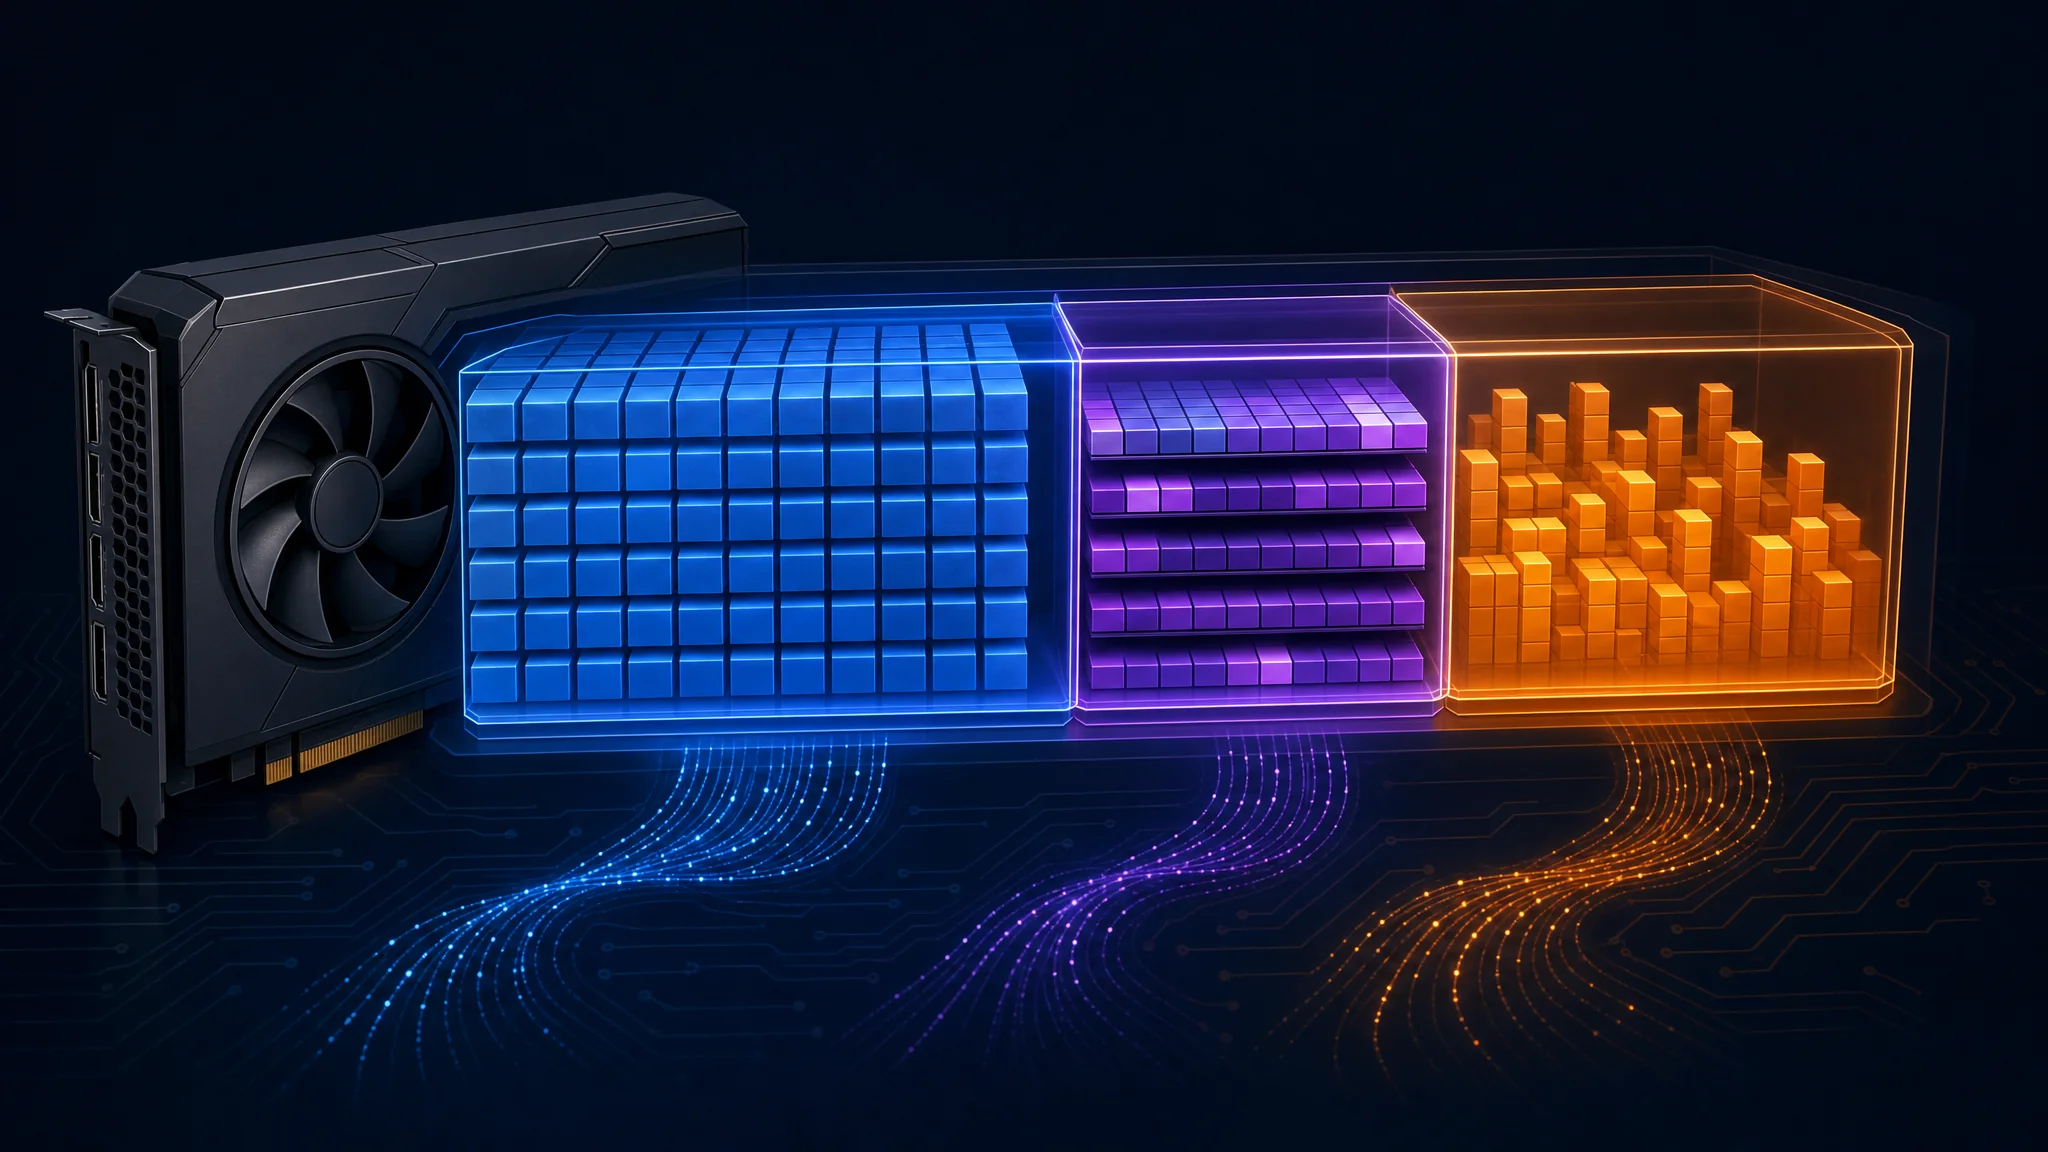
Azul representa pesos, roxo representa cache de contexto e laranja representa alocações de runtime. Os tamanhos são ilustrativos
Por que as velocidades diferem
Um rótulo de 16 GB descreve capacidade. A vazão também depende da largura de banda da memória, dos kernels de computação, do contexto ativo, do offload, do batching e da decodificação especulativa.
| Causa | O que inspecionar |
|---|---|
| Offload para CPU ou RAM | Posicionamento das camadas carregadas e localização do cache |
| Contexto longo | Tokens ocupados durante a medição |
| Diferenças de backend | Commit do runtime, driver e caminho do kernel |
| Decodificação especulativa | Rascunhos aceitos e alocações extras |
Para um modelo denso que gera um token por vez, a largura de banda dividida pelos bytes de pesos residentes fornece uma estimativa aproximada baseada apenas na largura de banda. A 448 GB/s e 11,8 GB de pesos, o quociente é cerca de 38 tokens por segundo. Leituras do cache e computação adicionam trabalho, enquanto decodificação especulativa e batching mudam as hipóteses.
Não trate esse quociente como um limite superior universal. Uma taxa de saída maior não invalida automaticamente um benchmark. Verifique se uma passagem do modelo-alvo aceitou vários tokens de rascunho.
A predição de múltiplos tokens, ou MTP, precisa de um modelo e runtime compatíveis. Compare execuções ativadas e desativadas em contexto ocupado curto e longo. Pesos extras e estado de rascunho consomem memória, mas nenhuma regra universal exige desativar MTP depois de 32K tokens.
Meça a primeira resposta
O prefill processa o prompt antes da geração. O decode produz a resposta. Um decode rápido esconde uma primeira resposta lenta quando a tarefa começa com um prompt grande sem cache.
Divida os tokens do prompt sem cache pela vazão medida de prefill para estimar o tempo de processamento. Para um prompt novo de 30.000 tokens, duas taxas ilustrativas produzem estas esperas:
| Taxa de prompt de exemplo | Tempo de processamento calculado |
|---|---|
| 750 tokens/s | 40 segundos |
| 150 tokens/s | 200 segundos |
Esses exemplos descrevem o tempo de processamento, excluindo carregamento do modelo e overhead da solicitação. Tamanho do prompt, tamanho do lote, formato do modelo e backend afetam a taxa medida.
Meça uma solicitação fria e uma continuação com um prefixo reutilizável separadamente. A reutilização do prefixo evita processar parte da entrada repetida. Registre o tempo até o primeiro token junto com a taxa de decode e a duração total da tarefa.
Compare configurações completas de GPU
Compare preço de compra, memória utilizável, largura de banda e caminho de software em conjunto. Uma placa mais barata perde a vantagem se sua carga exigir recursos sem suporte ou levar mais tempo que sua meta de latência.
| Placa desktop de 16 GB | Largura de banda da memória |
|---|---|
| RX 9060 XT | 320 GB/s |
| RTX 5060 Ti | 448 GB/s |
| RX 9070 | 640 GB/s |
| RX 9070 XT | 640 GB/s |
As especificações da RX 9070 da AMD e as especificações da RX 9070 XT confirmam capacidade de 16 GB e largura de banda de até 640 GB/s. A comparação entre 640 e 448 resulta em cerca de 43% mais largura de banda teórica. Uma melhoria de 43% na inferência não decorre dessas especificações.
Escolha benchmarks que usem seu modelo e backend pretendidos. Para prompts curtos e geração sustentada, dê mais peso ao desempenho de decode. Para análise de repositórios, priorize prefill frio, velocidade em contexto longo e conclusão bem-sucedida da tarefa. Verifique o software disponível antes de comprar qualquer fornecedor.
Macs e rótulos de laptops
Um Mac com Apple silicon de 16 GB compartilha memória entre CPU, GPU, sistema operacional e aplicativos. Uma GPU discreta de 16 GB possui memória de vídeo dedicada além da RAM do sistema. Essas capacidades não descrevem orçamentos equivalentes para modelos.
A Apple expõe um tamanho recomendado do conjunto de trabalho da GPU . Inspecione o limite informado pelo runtime e a pressão de memória do sistema. Deixe espaço para o macOS e outros aplicativos em vez de orçar todo o pool compartilhado para inferência.
Para laptops, verifique o SKU exato do fabricante, a memória dedicada, o limite de potência da GPU e a refrigeração. A página da família RTX 5060 da NVIDIA lista variantes de memória da RTX 5060 Ti para desktop. O nome da família sozinho não estabelece 16 GB, e resultados de desktop não estabelecem vazão de laptop.
A propriedade compensa?
A propriedade compensa financeiramente quando as cobranças de hospedagem evitadas excedem os custos de operação e recuperam a compra do hardware. Comece com um exemplo somente de saída: uma placa de US$ 789, 35 tokens de saída/s, 180 W durante a geração, eletricidade a US$ 0,18/kWh e US$ 2,95 por milhão de tokens de saída hospedados. Esses são valores ilustrativos. Substitua-os pela sua cotação, potência medida, tarifa de eletricidade e preço do provedor.
Hours per million output tokens = 1,000,000 ÷ 35 ÷ 3,600 = 7.94
Electricity per million = 7.94 × 0.180 kW × $0.18/kWh = $0.257
Savings per million = $2.95 - $0.257 = $2.693
Break-even output = $789 ÷ $2.693 = 293 million tokens
Continuous generation time = 293 × 7.94 ÷ 24 = about 97 days
Com oito horas de geração ininterrupta por dia, o mesmo cálculo leva cerca de 291 dias. Oito horas com um assistente aberto diferem de oito horas gerando tokens.
Com preço hospedado de US$ 0,16 por milhão, a eletricidade local neste cenário já custa mais que a hospedagem. Não existe ponto de equilíbrio positivo somente na saída sob essas hipóteses.
Use os preços atuais de modelos da OpenRouter do provedor selecionado, incluindo cobranças de entrada e de entrada em cache. Meça a energia de todo o sistema, incluindo o prefill. Adicione upgrades, energia ociosa, manutenção e valor de revenda esperado. Compare trabalho aceito, pois tentativas repetidas e diferenças de qualidade mudam o custo por tarefa.
Quando adicionar memória
Passe de 16 GB quando sua carga medida exceder o contexto disponível com qualidade e latência aceitáveis. Sessões diárias longas de agentes, solicitações simultâneas ou pesos de maior precisão tornam uma capacidade maior útil.
Duas placas de 16 GB precisam de suporte explícito do runtime. Elas não viram uma alocação transparente de 32 GB. Cada dispositivo precisa de buffers, e a comunicação usa a interconexão do host.
| Estratégia de divisão | Principal compromisso |
|---|---|
| Divisão por camadas | Camadas diferentes ocupam dispositivos diferentes |
| Divisão por tensor ou linha | O trabalho dentro das camadas adiciona comunicação |
| CPU mais GPU | Mais capacidade com outro perfil de latência |
Uma segunda placa merece consideração quando sua placa-mãe, fonte, refrigeração e backend já suportam o plano. Compare o custo completo do sistema com uma GPU única maior. O guia de hardware Qwen de 32 GB aborda essas alternativas.
Solução de problemas e próximos passos
Se o carregamento falhar, reduza o contexto e inspecione as alocações. Se a velocidade cair durante uma sessão, verifique o contexto ocupado e o offload para CPU. Se a primeira resposta travar, meça o prefill frio. Se o uso de ferramentas falhar depois da compressão, compare a mesma tarefa com um modelo de maior precisão.
Salve um teste repetível com suas instruções normais, arquivos e saídas de ferramentas. Registre a revisão do modelo, a versão do runtime, a precisão do cache, o contexto ocupado, o pico de memória, a latência do primeiro token, a velocidade de decode e se a tarefa passou. Repita perto da sessão mais longa esperada.
Use o guia de modelos locais e contexto para comparar alternativas menores. Escolha o menor modelo que atenda aos seus requisitos de qualidade e reserve memória suficiente para a tarefa completa. Nessas condições, 16 GB são um alvo útil para uma estação de trabalho.
Related Posts