(Última atualização:
10/10/2026)
— Escrito por
SimeonOnSecurity— 7 minutos de leitura
Compare o agente de terminal do Copilot com a experiência no VS Code, incluindo contexto do editor, diferenças visuais, modo Agent, integração CLI e políticas da conta.
(Última atualização:
10/10/2026)
— Escrito por
SimeonOnSecurity— 12 minutos de leitura
Compare Deep Agents, Claude Agent SDK, OpenAI Agents SDK, Pydantic AI, Pi e LangGraph por execução de ferramentas, memória, recuperação e esforço de integração.
(Última atualização:
10/10/2026)
— Escrito por
SimeonOnSecurity— 12 minutos de leitura
Como os Context Language Models editam a memória de agentes, o que os benchmarks demonstram e como custos de cache, capacidade do modelo e notas não confiáveis afetam a confiabilidade.
(Última atualização:
10/10/2026)
— Escrito por
SimeonOnSecurity— 6 minutos de leitura
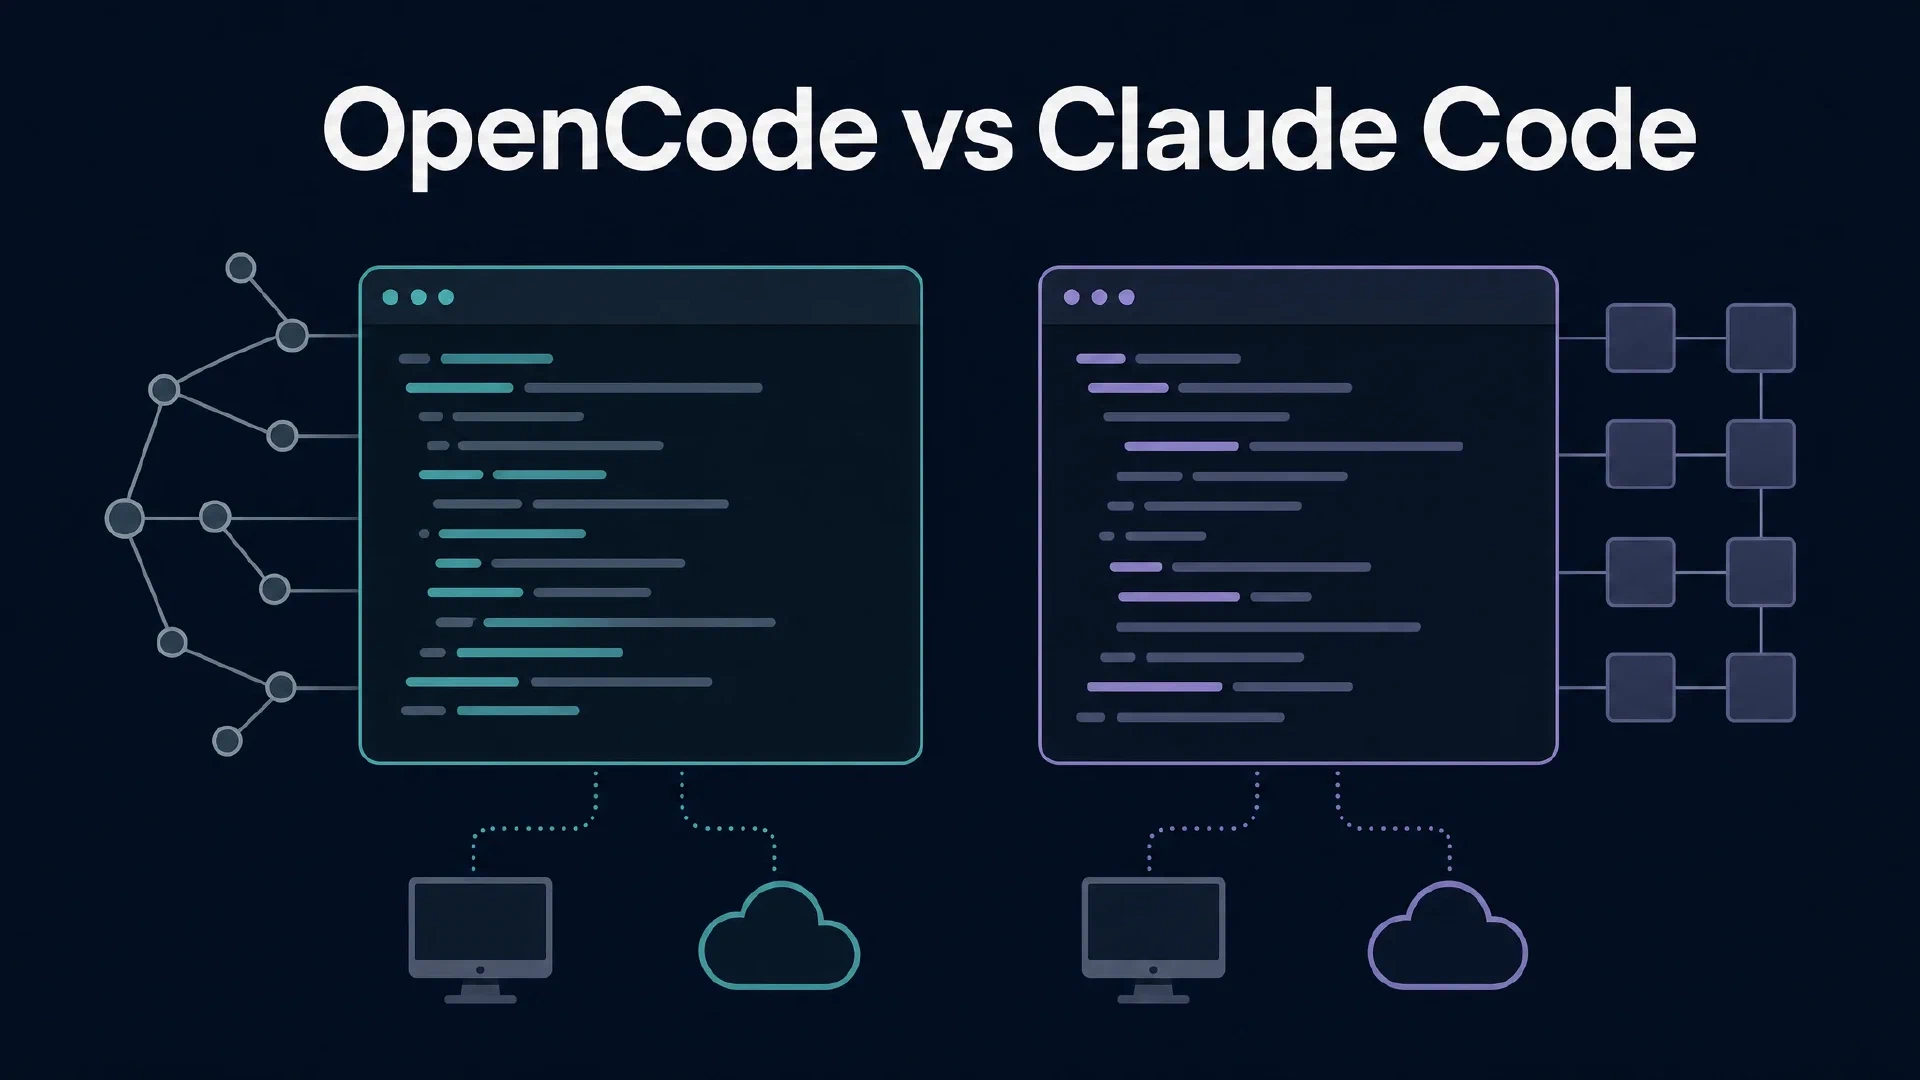
Compare os clientes de terminal e desktop do OpenCode por meio da arquitetura do servidor, configuração do provedor, scripts, estado da sessão e solução de problemas.
(Última atualização:
10/10/2026)
— Escrito por
SimeonOnSecurity— 11 minutos de leitura
Execute um agente de programação local com Strata e OpenCode. Examine os resultados relatados da RTX 4060 Ti, os requisitos de RAM, a reutilização de prompts, os limites de raciocínio e os limites de substituir uma assinatura paga.
(Última atualização:
10/10/2026)
— Escrito por
SimeonOnSecurity— 12 minutos de leitura
Um guia prático de outubro de 2026 para escolher modelos de IA locais para agentes de programação. Compare memória da GPU, crescimento do KV cache, tamanho do contexto, qualidade da quantização, processamento de prompts, configurações de raciocínio e custos de aluguel na nuvem.
(Última atualização:
10/10/2026)
— Escrito por
SimeonOnSecurity— 11 minutos de leitura
Diagnostique respostas inconsistentes do OpenRouter, compare limites de endpoints e custos de cache, e configure o roteamento de provedores sem desativar controles de qualidade por acidente.
(Última atualização:
10/10/2026)
— Escrito por
SimeonOnSecurity— 12 minutos de leitura
Um guia prático de outubro de 2026 para executar um modelo Qwen 27B com 32 GB de memória útil do acelerador. Compare GPUs únicas, configurações com duas placas, memória unificada, placas de data center usadas, computação alugada, suporte de software e limites de contexto completo.
(Última atualização:
10/10/2026)
— Escrito por
SimeonOnSecurity— 10 minutos de leitura
A versão de 64GB do DGX Spark da NVIDIA mostra como a pressão sobre a oferta de memória está moldando o hardware de IA local. Este guia explica o corte de capacidade, os compromissos da memória unificada e por que o alívio no DRAM é improvável antes do fim de 2027.