Programação local com IA em uma GPU de 16 GB: Strata, OpenCode e Qwen3.8
Table of Contents
Um agente de programação local em uma GPU de 16 GB é uma opção prática para tarefas de desenvolvimento delimitadas. Strata e OpenCode combinam inferência local com edição de arquivos, comandos de shell e execução de testes. Uma execução relatada do Qwen3.8-Flash-Next em uma RTX 4060 Ti concluiu uma aplicação, mudanças posteriores e um protótipo de jogo de corrida sem chamadas de inferência pagas.
Substituir uma assinatura exige um teste mais amplo. Os resultados publicados demonstram uma configuração funcional em uma máquina. Eles não estabelecem equivalência com serviços pagos de programação em diferentes linguagens, repositórios ou tarefas difíceis de depuração. O hardware também inclui 64 GB de RAM do sistema, que armazena grande parte do modelo.
Principais conclusões
- 16 GB descreve a memória da GPU, não a memória total necessária para a configuração relatada.
- A reutilização de prompts importa porque agentes de programação enviam repetidamente históricos de conversa sobrepostos.
- O raciocínio precisa de um orçamento para que o planejamento deixe espaço para código e chamadas de ferramentas.
- Passar nos testes gerados é evidência parcial, enquanto Docker e jogabilidade exigem verificações separadas.
- Gasto zero com API exclui os custos de posse, eletricidade e tempo de manutenção.
Pré-requisitos: Um computador compatível, armazenamento livre suficiente para o modelo escolhido, Git, Node.js com npm e familiaridade com ferramentas de terminal. Reproduza a configuração IQ3_S relatada com 64 GB de RAM. Use o instalador atual do Strata para verificar outras configurações.
Tempo e dificuldade: Intermediário. Reserve tempo para baixar modelos grandes e instalar tudo antes de avaliar a velocidade de conclusão das tarefas. Os tempos relatados excluem a configuração.
Configuração testada
| Componente | Configuração relatada |
|---|---|
| GPU | NVIDIA RTX 4060 Ti, 16 GB de VRAM |
| CPU | Intel Core i5-11600K |
| Memória do sistema | 64 GB de RAM |
| Armazenamento | SSD NVMe |
| Modelo | Qwen3.8-Flash-Next, 125B MoE, IQ3_S |
| Motor de inferência | Strata |
| Agente de programação | OpenCode |
| Contexto configurado | 65.536 tokens |
| Limite de saída configurado | 16.384 tokens |
A configuração e os resultados publicados pelo NetworkCoder fornecem esses números. O repositório de testes relata o carregamento de 46,84 GiB de pesos de especialistas em 28 segundos, com 4.431 especialistas ocupando 8,45 GiB de memória da GPU. Essas medições descrevem a execução testada, não uma alocação garantida em outra versão do motor.
A compatibilidade atual é mais ampla que este teste. Conforme verificado em 6 de outubro de 2026, o projeto Strata documenta placas NVIDIA e AMD selecionadas com pelo menos 12 GB de VRAM, além de modelos menores para sistemas com 32 GB de RAM. Essas opções não reproduzem o experimento com GPU de 16 GB, RAM de 64 GB e IQ3_S. Verifique a GPU exata, a variante do modelo e o suporte do runtime antes de comprar hardware.
Onde o modelo fica
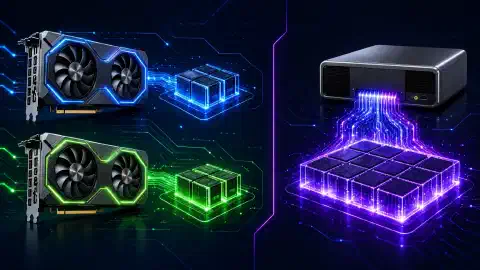
Uma mistura de especialistas, ou MoE, ativa um subconjunto das redes especialistas de um modelo para cada token. Isso reduz o cálculo ativo em comparação com usar todos os parâmetros em cada etapa. Os pesos restantes ainda precisam de armazenamento e de um caminho até o cálculo.
A execução híbrida do Strata mantém especialistas usados com frequência na GPU e conserva a coleção de especialistas na RAM do sistema. A CPU calcula especialistas não armazenados em cache no local, enquanto a GPU processa os especialistas em cache. O armazenamento também guarda os arquivos do modelo e os dados de consulta. O sistema não coloca o modelo 125B inteiro em 16 GB de VRAM.
A memória da GPU tem usos concorrentes. Alocações do runtime, estado de atenção e cache de especialistas dividem um recurso limitado. Mais espaço para contexto reduz a capacidade restante do cache de especialistas. As versões atuais do Strata também oferecem streaming do cache KV, então a disposição exata difere de uma configuração antiga. Consulte a documentação técnica da sua versão do motor.
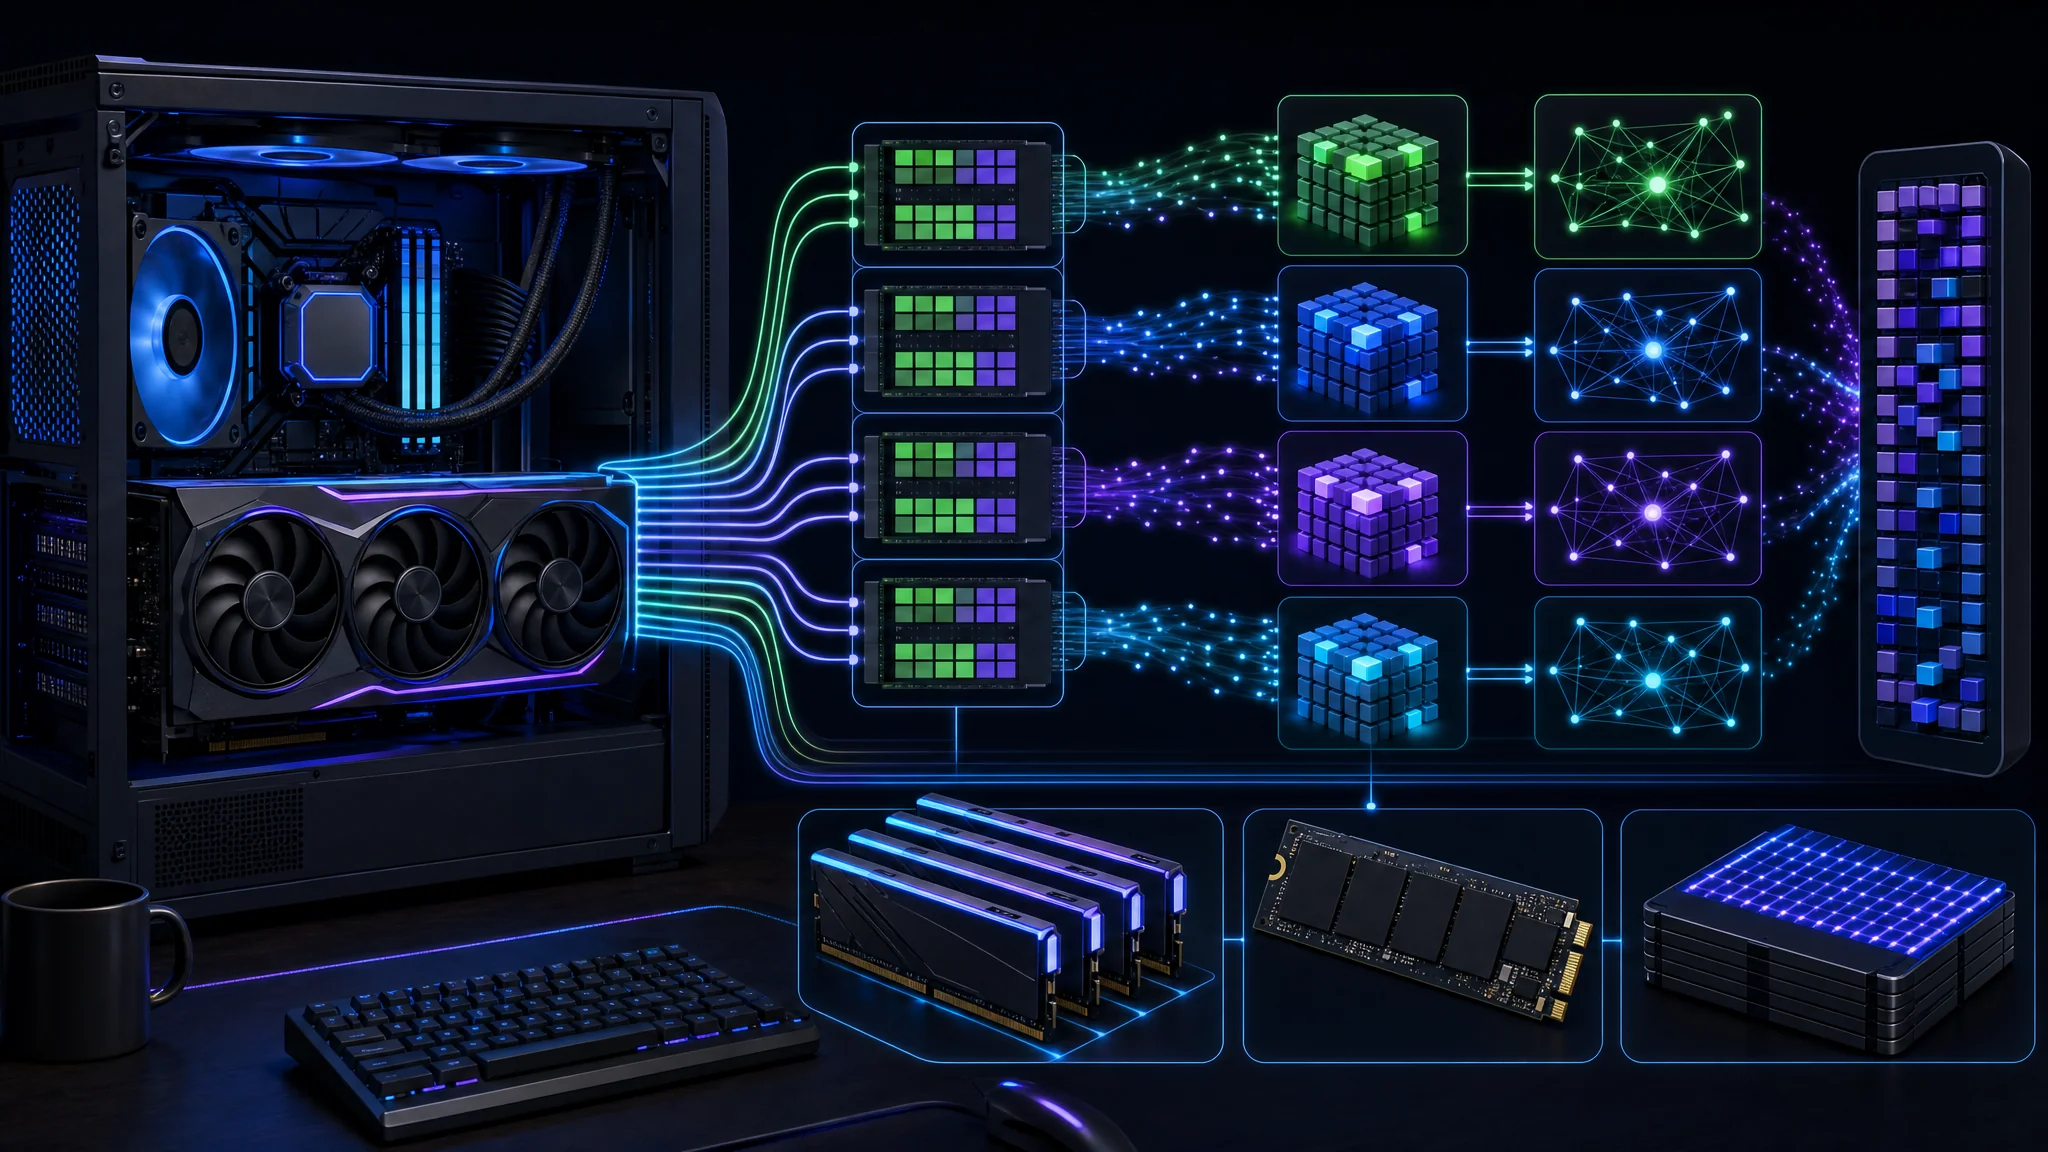
A GPU é uma parte do sistema de inferência, junto da execução na CPU, da RAM do sistema e do armazenamento
A reutilização de prompts muda a velocidade
Um agente de programação executa um ciclo: lê a tarefa, solicita uma ação de ferramenta, recebe o resultado e decide a próxima ação. Conteúdo de arquivos, erros e resultados de testes se acumulam na conversa. Agentes também compactam ou selecionam contexto, então nem toda implementação reenvia para sempre um histórico completo sem mudanças.
Prefill processa tokens de entrada antes da geração. Decode produz a resposta. Um sistema com decode rápido, mas prefill repetido lento, ainda deixa você esperando entre chamadas de ferramentas.
A medição relatada de 44 mil tokens usou reutilização de prefixo. O Strata reutilizou conteúdo de conversa processado antes, deixando o prompt crescente pronto em aproximadamente um a três segundos. Isso é evidência útil para uma sessão contínua de agente. Não é evidência de processar 44.000 tokens totalmente novos do zero em um segundo.
| Medição | O que registrar |
|---|---|
| Prompt frio | Tempo para conteúdo novo sem estado de prefixo reutilizável |
| Continuação quente | Tempo após anexar o resultado de uma ferramenta ao contexto existente |
| Velocidade de geração | Tokens por segundo durante a resposta |
| Duração da tarefa | Planejamento, geração, ferramentas, testes e novas tentativas juntos |
Dois caches têm funções diferentes. O cache de especialistas mantém pesos usados com frequência perto do cálculo da GPU. A reutilização de prefixo evita repetir trabalho em entradas anteriores. Uma alta taxa de acerto do cache de especialistas não prova um acerto no cache de prompts.
O que as tarefas demonstraram
| Tarefa | Tempo relatado | Resultado relatado |
|---|---|---|
| Criar gerenciador de tarefas | 3 min 38 s | API Express, interface, testes 5/5 |
| Corrigir edição e adicionar datas | 4 min 58 s | Mudanças concluídas, testes 6/6 |
| Adicionar exportação, importação e empacotamento | 3 min 48 s | Testes 7/7, build Docker não verificado |
| Jogo de corrida, primeira tentativa | 6 min 35 s | Saída esgotada durante o raciocínio, sem código |
| Jogo de corrida, nova tentativa com orçamento | 4 min 51 s | Jogo gerado, sintaxe JavaScript verificada |
O arquivo de resultados publicado registra velocidades de saída de 48–52 tokens por segundo para a primeira tarefa, 40–43 para a segunda e 37–44 para a terceira. “Até 52” é um pico dentro dessas observações, não uma taxa sustentada para toda tarefa.
As três primeiras tarefas estendem uma aplicação. As contagens 5/5, 6/6 e 7/7 descrevem conjuntos de testes sucessivos. Somá-las não estabelece 18 capacidades independentes. Testes escritos pelo mesmo agente também precisam de revisão quanto à cobertura e às asserções relevantes.
A recuperação do ambiente fez parte do trabalho. O agente se recuperou de um comando de shell inadequado e identificou um servidor de aplicação antigo durante os testes. Esses são comportamentos úteis, embora encerrar um processo existente exija permissões deliberadas em um ambiente de desenvolvimento compartilhado.
Docker permaneceu sem verificação. O agente escreveu um Dockerfile, mas não tinha um motor Docker em execução para o build. Testes da aplicação aprovados fora do contêiner não estabelecem uma imagem funcional. A nova tentativa do jogo também verificou a sintaxe e abriu um navegador, enquanto o agente não tinha confirmação visual direta da jogabilidade.
Reserve espaço para a saída
{
  "reasoning_budget_tokens": 8000
}
Mescle esta configuração ao strata-iq3_s.json existente, preservando os outros campos, e reinicie o modelo Strata selecionado. É uma configuração do Strata, não um arquivo de configuração substituto do OpenCode. Verifique o orçamento ativo na saída de inicialização.
O Strata documenta um orçamento rígido de raciocínio que encerra a fase de pensamento e passa para uma resposta. Um valor definido na solicitação substitui o padrão configurado. Essa configuração difere de uma instrução geral de esforço de raciocínio, como baixo ou alto.
A primeira tentativa do jogo consumiu sua permissão de 16.384 tokens enquanto planejava. A nova tentativa aplicou um orçamento de pensamento de 8.000 tokens e entregou código. Isso apoia o uso de uma fase de raciocínio limitada para esta carga. Não estabelece 8.000 como a melhor configuração para toda tarefa.
O limite de saída restante é um máximo, não uma reserva garantida. Se um limite de 8.000 tokens fosse consumido por completo sob um limite total de 16.384, cerca de 8.384 tokens restariam antes de outras despesas. O log de resultados relata 11.054 tokens escritos na nova tentativa, sem uma divisão completa entre raciocínio e código. Não interprete isso como 8.000 tokens de raciocínio mais 11.054 tokens de código sob o mesmo limite.
Use um orçamento menor para edições estreitas, e teste orçamentos maiores para tarefas que exigem mais análise. Inspecione a saída completa dos arquivos, o status de término e os resultados dos testes. Mais tempo de planejamento só ajuda quando melhora a mudança entregue.
Conecte Strata e OpenCode
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
Este é o ponto de entrada de configuração para Linux. Revise as instruções atuais de instalação e use START-HERE.bat para o caminho documentado no Windows. Selecione a variante original Qwen3.8-Flash-Next IQ3_S e um contexto de 65.536 tokens para aproximar a configuração relatada. Salve a versão do motor e os arquivos de modelo selecionados nas anotações do benchmark.
npm install -g opencode-ai
Instale o OpenCode usando as
instruções oficiais
. Em um terminal separado, defina STRATA_BASE_URL como a base da API local exibida pelo Strata, incluindo o sufixo /v1. Mantenha a inferência ligada à máquina local nesta configuração.
{
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata local",
      "options": {
        "baseURL": "{env:STRATA_BASE_URL}",
        "apiKey": "local"
      },
      "models": {
        "qwen3.8-flash-next-iq3_s": {
          "name": "Qwen3.8-Flash-Next IQ3_S",
          "limit": { "context": 65536, "output": 16384 }
        }
      }
    }
  },
  "model": "strata/qwen3.8-flash-next-iq3_s"
}
Mescle o bloco do provedor em ~/.config/opencode/opencode.json, preservando as configurações existentes. Isso adapta o
exemplo de configuração publicado
carregando o endpoint local a partir de uma variável de ambiente. O OpenCode documenta
provedores personalizados
e
substituição de ambiente
.
local é uma credencial de espaço reservado, seguindo o exemplo de configuração local sem autenticação. Ela não protege um servidor. Se a instância do Strata ativar autenticação, forneça a credencial configurada pelo mecanismo local apropriado de segredos.
Inicie opencode em uma cópia descartável do projeto e selecione o modelo configurado. Verifique o provedor selecionado antes de enviar código. A declaração de contexto do cliente não aumenta o contexto configurado no servidor, e uma janela de 65.536 tokens não deixa 65.536 tokens para entrada quando também é necessário espaço para saída.
Inferência local e permissões
{
  "permission": {
    "edit": "ask",
    "bash": "ask"
  }
}
Mescle estas permissões iniciais à configuração do OpenCode enquanto avalia o agente. A documentação de permissões explica os controles disponíveis. Alterações de arquivos e execução de shell afetam sua máquina, independentemente de onde a inferência é executada.
Inferência local não torna toda ferramenta local. Downloads de pacotes, ferramentas web, integrações externas e compartilhamento opcional ainda envolvem serviços de rede. Revise as ferramentas habilitadas antes de lidar com repositórios privados. “O modelo roda localmente” é uma afirmação mais restrita que “nada sai do computador”.
Solução de problemas na primeira execução
| Sintoma | Verifique primeiro |
|---|---|
| Provedor indisponível | Strata está em execução e a variável de ambiente chega ao processo do OpenCode |
| Modelo ausente na seleção | ID do provedor e ID do modelo correspondem à configuração salva |
| Erro de limite de contexto | Tamanho do prompt mais a saída solicitada cabem na janela ativa do servidor |
| Planejamento sem código | Orçamento de raciocínio, limite total de saída e status de término |
| Continuação lenta | Reutilização de prefixo, pressão de memória, comportamento do cache de especialistas e processos concorrentes |
| Comando Docker falha | Existe um motor funcional, em vez de apenas seu cliente de linha de comando |
Altere uma configuração por vez e repita a mesma tarefa a partir de um estado inicial salvo. Isso separa uma melhoria de configuração de um prompt diferente ou de um teste mais fácil.
Ele substitui uma assinatura?
| Vale testar a configuração local | Mantenha outra opção disponível |
|---|---|
| Hardware compatível existente | Comprar hardware somente para uma carga não testada |
| Mudanças delimitadas em aplicações | Repositórios grandes e desconhecidos e migrações difíceis |
| Testes de aceitação repetíveis | Tarefas sem meios confiáveis de verificar a correção |
| Tempo para manutenção do runtime | Trabalho que exige pouca configuração e suporte |
Gasto zero com API é relevante, sobretudo quando o hardware já está disponível. Ele exclui eletricidade, depreciação do hardware, armazenamento e tempo de manutenção do ambiente. O campo de custo zero exibido também não mede essas despesas.
Uma comparação de assinaturas exige tarefas equivalentes. Execute o mesmo repositório inicial, as mesmas instruções e as mesmas verificações de aceitação nos dois sistemas. Registre novas tentativas e correções humanas junto do tempo decorrido. Inclua a primeira tentativa fracassada do jogo ao avaliar o fluxo completo, em vez de relatar apenas a nova tentativa bem-sucedida.
Um agente local útil não precisa superar tudo. Se ele trata suas edições rotineiras com consistência e deixa um pequeno conjunto de tarefas difíceis para outra ferramenta, ele já muda quais serviços pagos você precisa. Decida com base no trabalho aceito em seus próprios projetos.
Demonstração e próximos passos
Para assistir depois: Demonstração do agente de programação local 125B . As medições acima pertencem ao teste publicado, não a um benchmark independente feito para este artigo.
- Reproduza uma tarefa pequena com critérios de aceitação fixos e uma revisão inicial salva.
- Meça turnos frios e quentes em vez de tratar a reutilização de prefixo como velocidade de prefill frio.
- Verifique o empacotamento separadamente com um build de imagem bem-sucedido, inicialização e verificações no contêiner.
- Inspecione os testes gerados e adicione casos que a implementação não antecipou.
- Compare o trabalho concluído com sua ferramenta de programação atual antes de mudar assinaturas.
Para planejar hardware, leia o guia de modelos locais de IA e contexto de GPU . Para o comportamento de modelos hospedados, consulte o roteamento e os custos de provedores do OpenRouter .
Related Posts